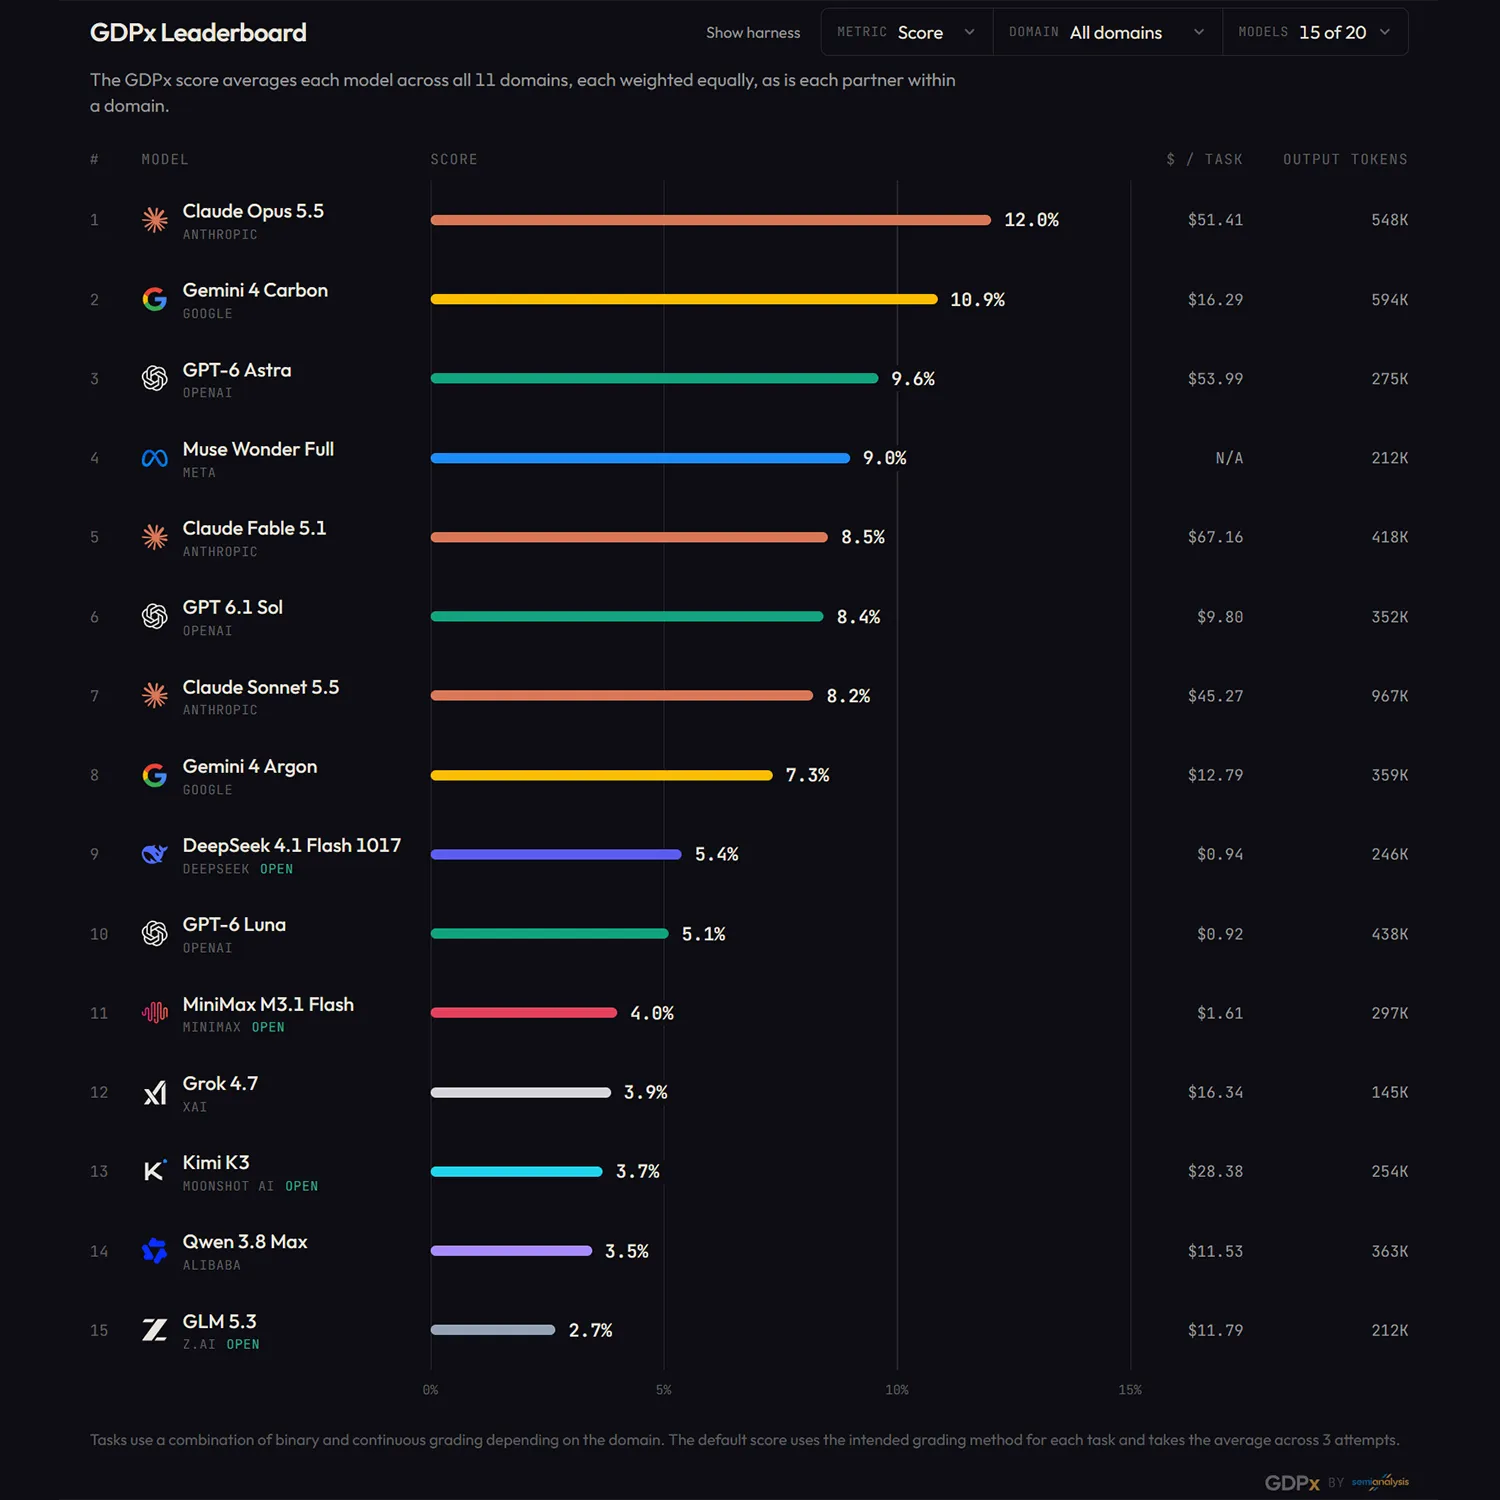
Selbst die besten KI-Modelle scheitern an einem Großteil anspruchsvoller Aufgaben aus Forschung, Entwicklung und Wirtschaft. Im neuen GDPx-Benchmark erreicht der Sieger Claude Opus 5.5 gerade einmal 12% und kostet pro Aufgabe mehr als 50$.
Anzeige
Claude Opus 5.5 führt zu einem hohen Preis
SemiAnalysis hat für GDPx Aufgaben aus elf Bereichen zusammengestellt. Dazu gehören Chipdesign, Cybersecurity, Biologie, Softwareentwicklung, Materialwissenschaft, Hardwaredesign, Finanzwesen und Recht. Die Modelle arbeiten dabei bis zu acht Stunden in realistischen Arbeitsumgebungen und müssen selbst Informationen finden, Entscheidungen treffen und Ergebnisse abliefern.
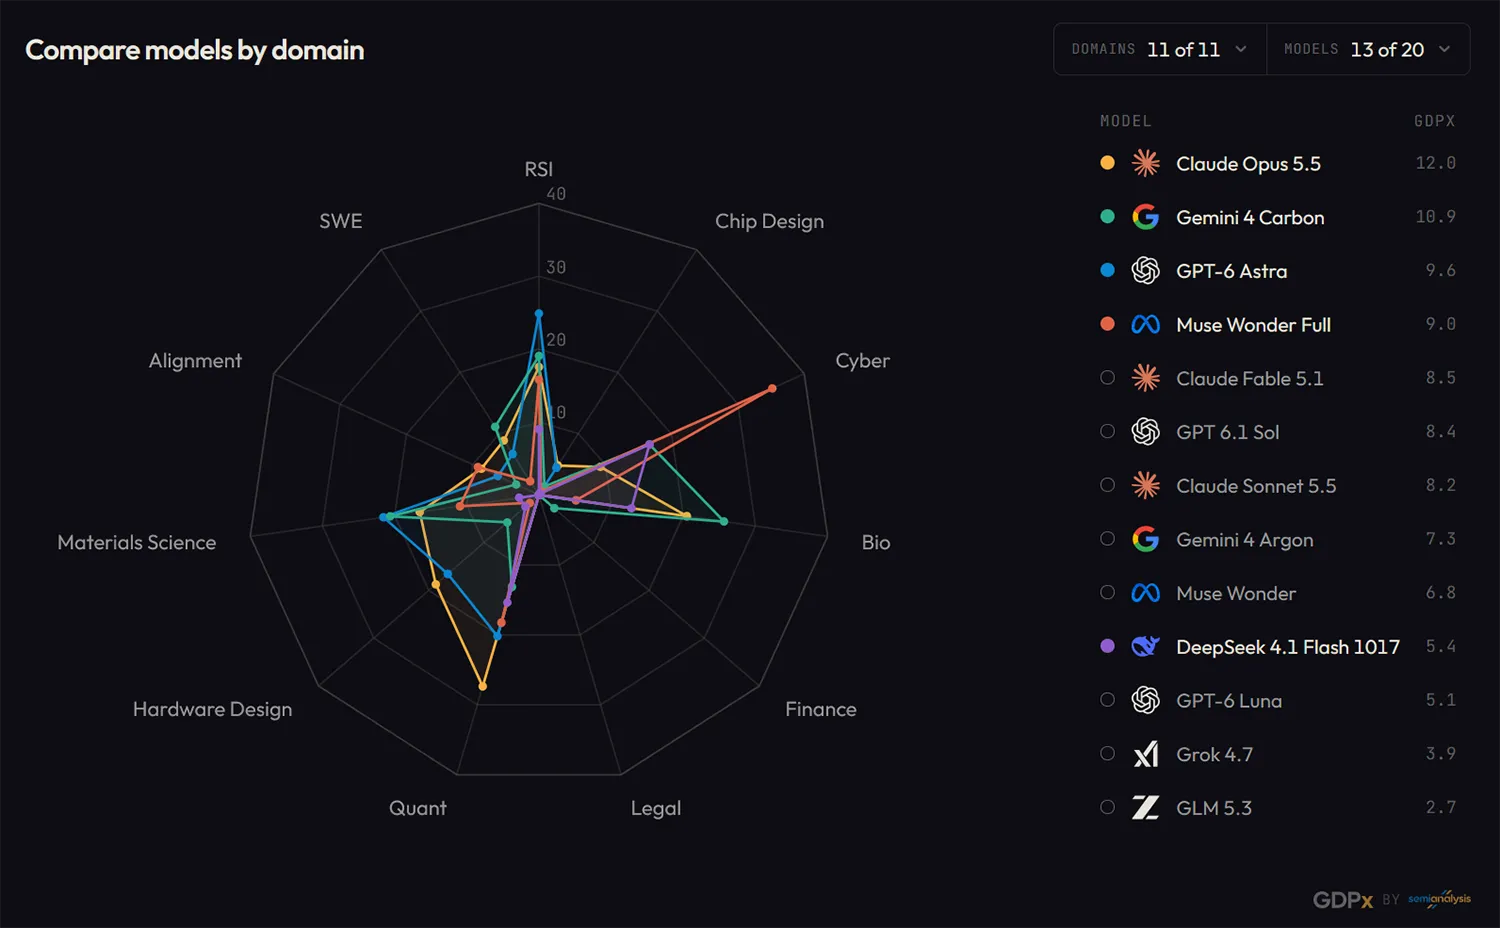
Claude Opus 5.5 führt mit 12% und kostet im Durchschnitt 51,41$ pro Aufgabe. Seine größten Stärken zeigt das Modell im Quant Trading sowie beim Hardware- und Chipdesign. Der hohe Preis zieht sich durch die Claude-Familie. Claude Fable 5.1 erreicht 8,5% für 67,16$ und ist damit sogar das teuerste Modell im Vergleich. Claude Sonnet 5.5 kommt auf 8,2% für 45,27$.
Quelle: SemiAnalysis
Gemini 4 Carbon wird zur großen Überraschung
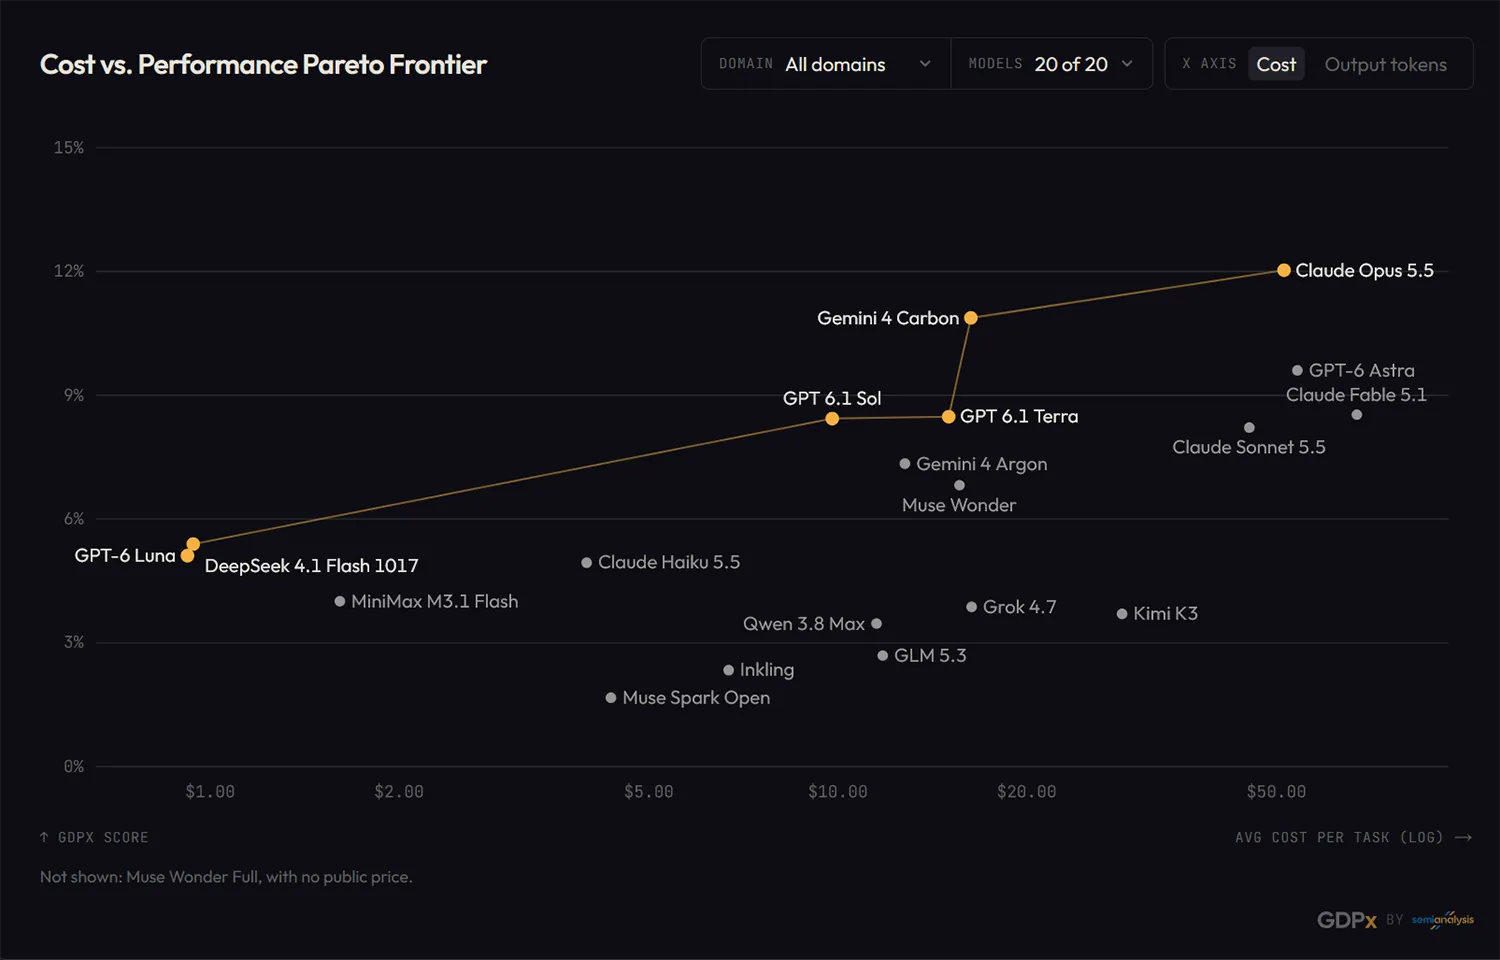
Gemini 4 Carbon landet mit 10,9% als einziges Modell in der Nähe von Opus 5.5. Eine Aufgabe kostet 16,29$ und damit weniger als ein Drittel. Google gewinnt mit Carbon die Bereiche Biologie und Softwareentwicklung. Gerade diese Kombination aus hoher Leistung und deutlich niedrigeren Kosten macht das Modell zum auffälligsten Ergebnis des Benchmarks.
Quelle: SemiAnalysis
OpenAI belegt mit GPT-6 Astra zwar Rang drei und erreicht 9,6%, verlangt jedoch 53,99$ pro Aufgabe. Interessanter ist GPT-6.1 Sol. Das Modell erzielt 8,4% für 9,80$ und kostet damit mehr als fünfmal weniger als Opus 5.5. GPT-6 Astra führt bei der rekursiven Selbstverbesserung und in der Materialwissenschaft.
Günstige Modelle setzen eigene Akzente
DeepSeek 4.1 Flash erreicht 5,4% für nur 0,94$ pro Aufgabe. GPT-6 Luna folgt mit 5,1% für 0,92$. Beide Modelle liegen bei der Gesamtleistung klar hinter der Spitze, bieten aber das stärkste Verhältnis aus Preis und Ergebnis.
Andere bekannte Modelle enttäuschen. Grok 4.7 erzielt 3,9% und kostet 16,34$ pro Aufgabe. Auch die chinesischen Modelle Kimi K3 mit 3,7%, Qwen 3.8 Max mit 3,5% und GLM 5.3 mit 2,7% bleiben weit zurück. DeepSeek bildet damit die auffällige Ausnahme unter den chinesischen Anbietern.
Die Ergebnisse unterscheiden sich je nach Fachgebiet stark. Muse Wonder Full ist mit deutlichem Abstand das beste Cybersecurity-Modell, während bei den besonders schweren Aufgaben aus Finanzwesen und Recht fast alle Modelle bei 0 landen. GDPx zeigt damit vor allem, dass ein hoher Gesamtwert allein noch keine gute Modellwahl ergibt. Fachgebiet und Kosten entscheiden mindestens ebenso stark.