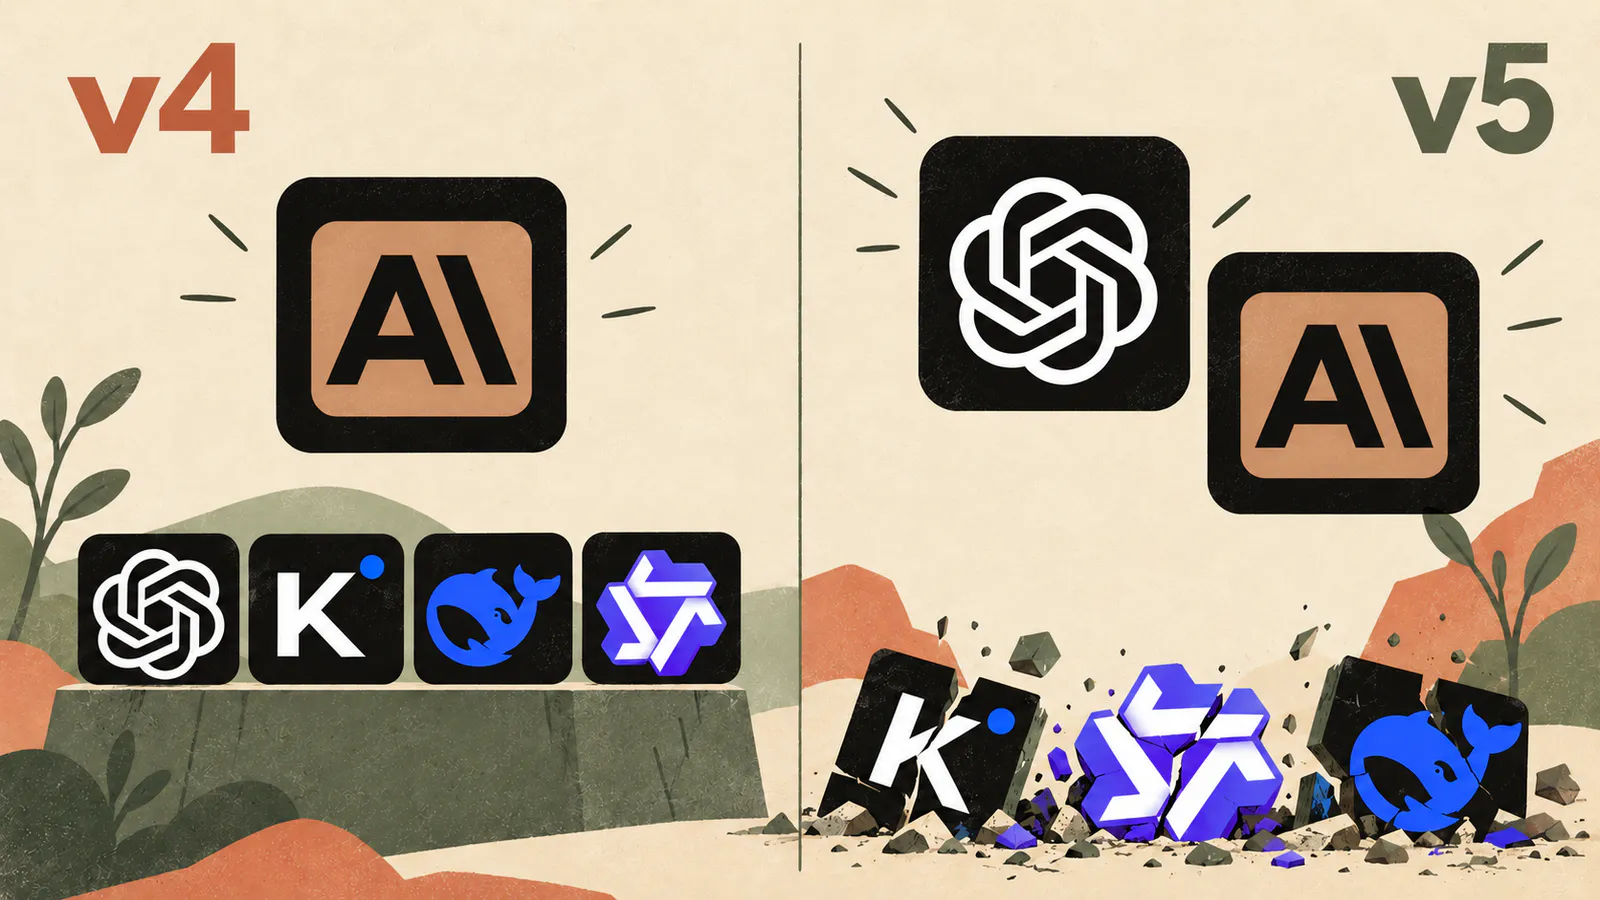
Artificial Analysis hat seinen Intelligence Index überarbeitet und damit die Rangliste der KI-Modelle kräftig durcheinandergewirbelt. OpenAI stellt plötzlich drei der fünf bestplatzierten Modelle, während Open Weight Modelle deutlich zurückfallen.
Neue Tests, neue Reihenfolge
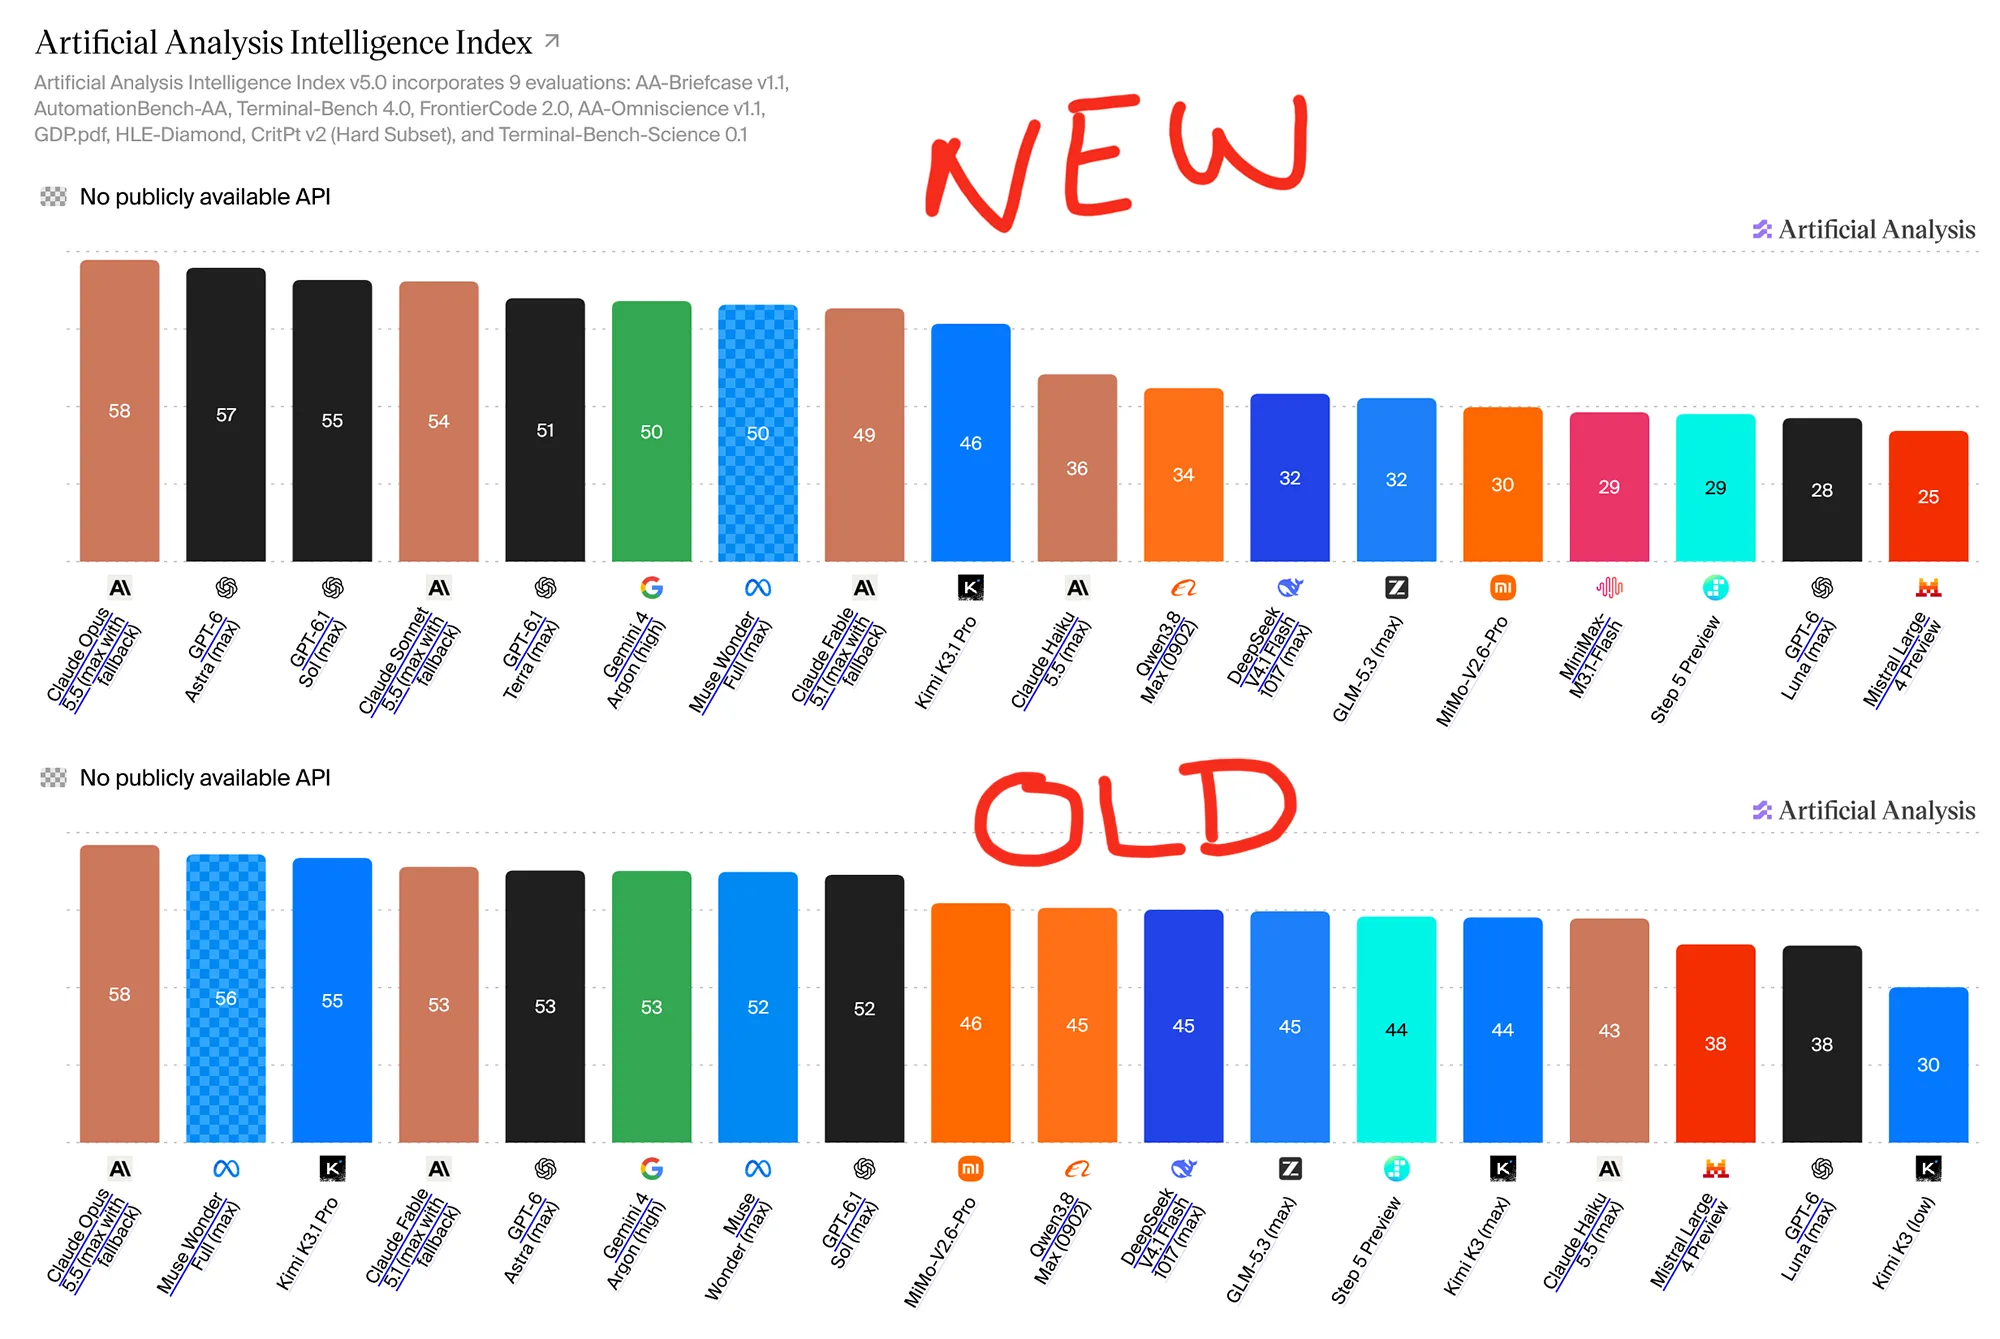
An der Spitze bleibt Claude Opus 5.5 von Anthropic mit 58 Punkten. Dahinter folgen GPT-6 Astra mit 57 und GPT-6.1 Sol mit 55 Punkten. Claude Sonnet 5.5 und GPT-6.1 Terra ergänzen die Top fünf mit 54 und 51 Punkten.
Quelle: Artificial Analysis
Vor der Umstellung lag Astra bei 53 Punkten und Sol bei 52. Kimi K3.1 Pro kam auf 55 Punkte und lag damit vor beiden. Jetzt erreicht das Modell nur noch 46 Punkte. Die Modelle sind dieselben, aber Artificial Analysis bewertet andere Aufgaben und gewichtet sie neu.
Auch innerhalb von OpenAI fällt eine große Lücke auf. Terra erreicht mit maximalem Reasoning 51 Punkte, das kleinere GPT-6 Luna fällt stark zurück auf nur noch 28 Punkte. Anthropic trifft es ebenfalls. Claude Fable 5.1 fällt von 53 auf 49 Punkte und liegt nun deutlich hinter Astra. Da Fable für eine Million Ausgabetoken 50 Dollar kostet, sollte es eigentlich mit Astra an der Spitze sein.
Anzeige
Open Weights fallen zurück
Kimi K3.1 Pro war vor wenigen Tagen noch das erste Open-Weight-Modell auf absolutem Top-Niveau. Jetzt liegt es gefühlt wieder ein halbes Jahr hinter den großen, amerikanischen Anbietern. Aus 3 Punkten Abstand sind 12 Punkte Abstand geworden.
Unter den Modellen mit verfügbaren Gewichten erreichen DeepSeek V4.1 Flash und GLM-5.3 jeweils 32 Punkte. Das sind 26 Punkte Abstand zum Spitzenreiter. Der Abstand hat sich also verdoppelt.
Preis Leistung und OpenAI Dominanz
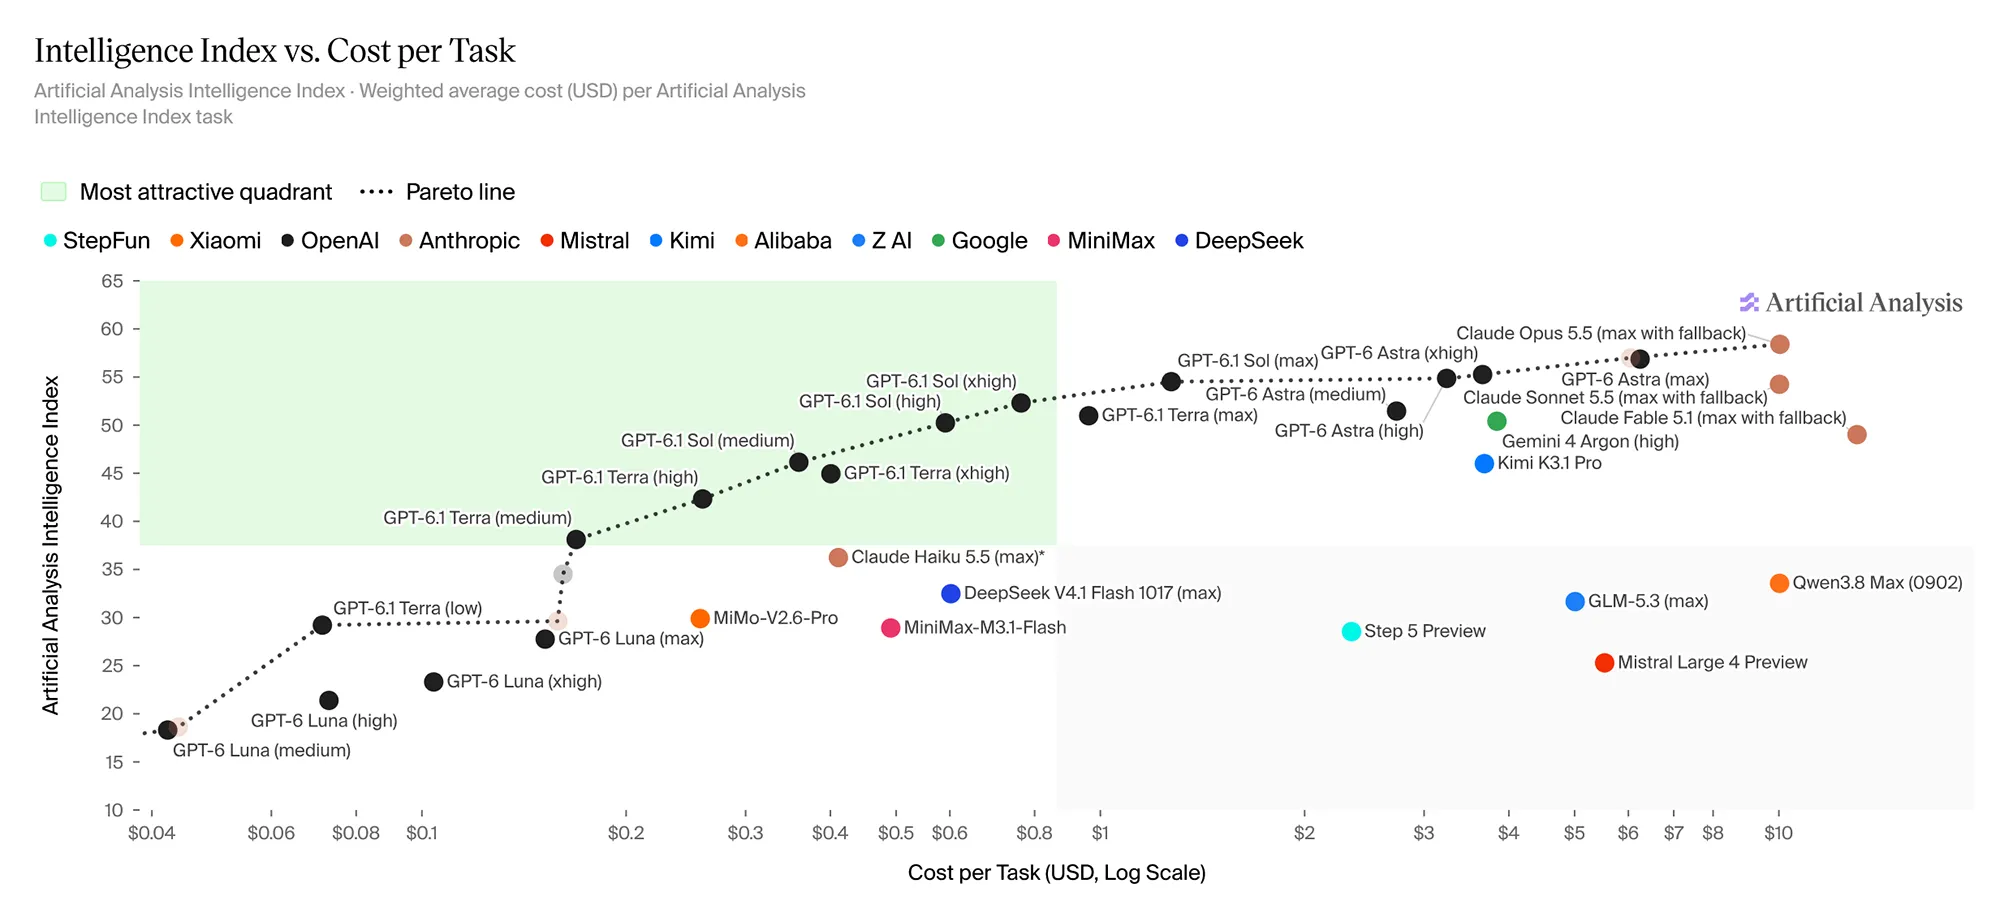
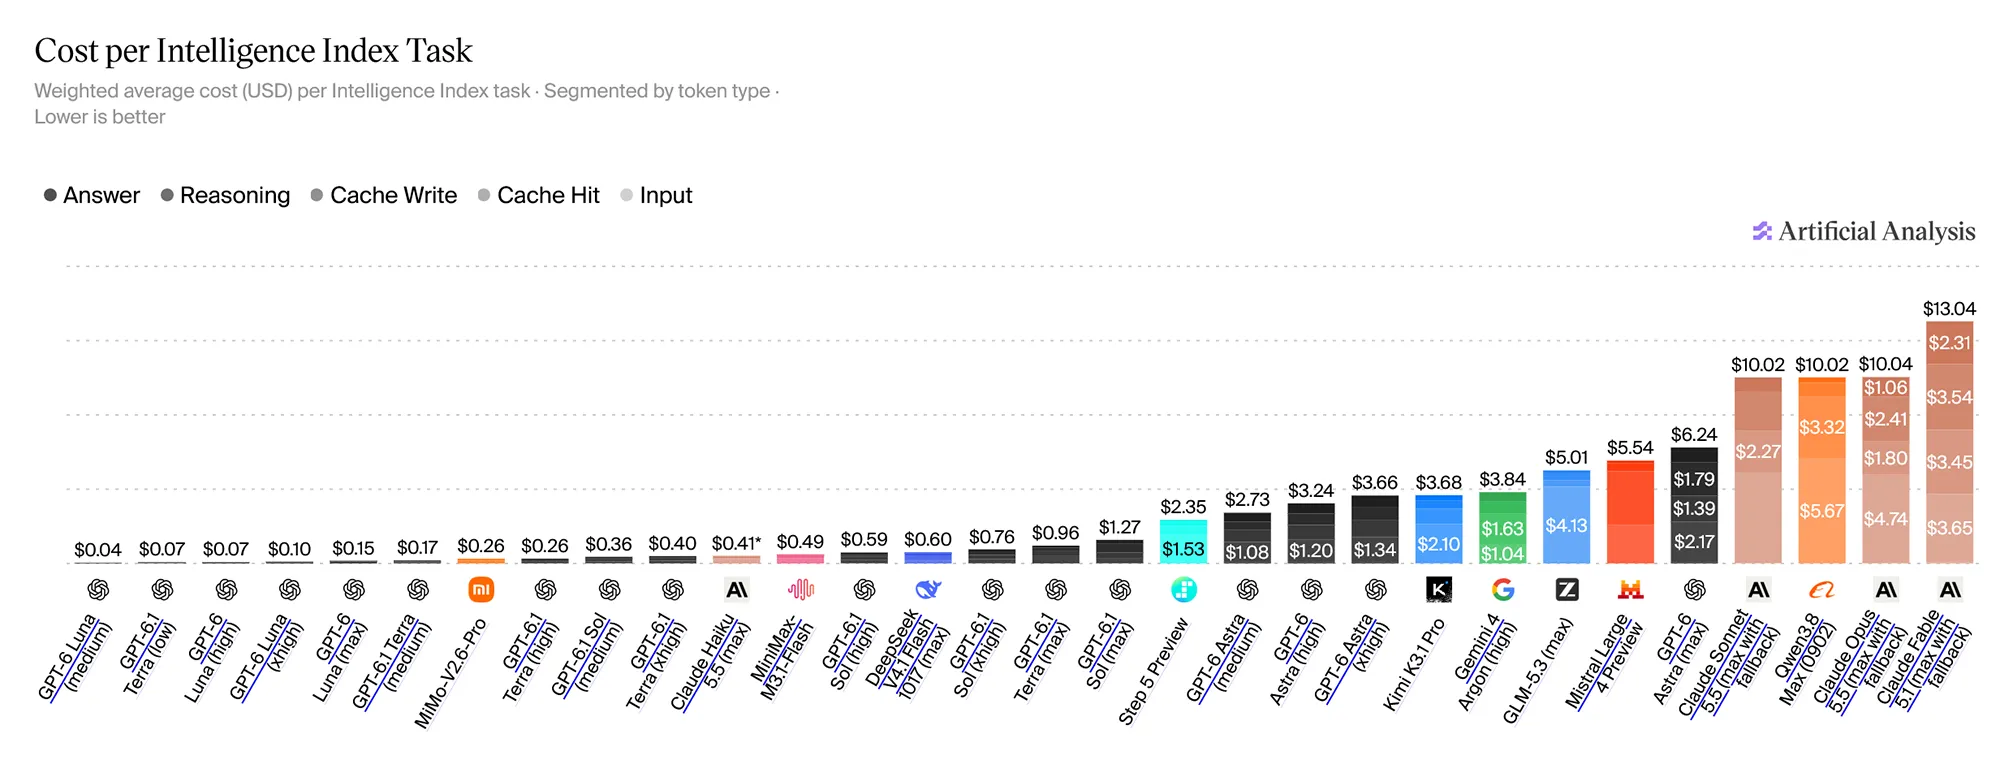
Wenn man sich das Preis-Leistungs-Verhältnis anschaut, dann ist in jedem Bereich OpenAI dominierend. Angefangen bei Luna (medium), über Terra (medium, high), über Sol (medium bis max), und abschließend mit Astra (xhigh, max).
Einzig Opus 5.5 kann bei der maximalen Leistung noch ein Wort mitreden. Fable, Sonnet und Haiku sind im Gegensatz zu den OpenAI Modellen in der Praxis einfach zu teuer. Alle anderen Modelle sowieso.
Wer den Maßstab setzt, hat Einfluss
Der Index umfasst jetzt neun Benchmarks aus Wissensarbeit, Programmierung, Wissenschaft und allgemeinen Fähigkeiten. Jede Kategorie zählt zu 25 Prozent. Neu sind FrontierCode 2.0 für Programmieraufgaben und Terminal-Bench-Science für wissenschaftliche Aufgaben. Andere Tests wurden ersetzt, überarbeitet oder entfernt.
Wie groß die Wirkung einer solchen Entscheidung ist, zeigt der plötzliche Wechsel in der Rangliste. Bei neuen Modellen verweisen viele auf Artificial Analysis. Ob ein Modell auf Platz drei oder zehn landet, prägt die Wahrnehmung und die Entscheidung für einen Anbieter.
Das schafft einen Anreiz zum »Benchmaxxing«. Hersteller optimieren ihre Modelle gezielt für bekannte Tests, weil schon wenige zusätzliche Punkte die Platzierung verbessern können, selbst wenn der Vorteil im Alltag wenig bringt.
Anzeige
Mehr Geheimhaltung, weniger Kontrolle
Artificial Analysis setzt deshalb stärker auf nicht öffentliche Testdaten oder zurückgehaltene Antworten. Sie machen 60 Prozent des Index aus und erschweren es, auf bekannte Aufgaben zu trainieren. Gleichzeitig können Außenstehende die Ergebnisse schlechter nachvollziehen und unabhängig überprüfen.
Gerade bei einer so einflussreichen Rangliste ist das ein Vertrauensproblem. Würde ein Anbieter die Plattform durch Zahlungen oder auf andere Weise beeinflussen, könnten sich Platzierungen verschieben, ohne dass Außenstehende die Ursache erkennen.
Am Ende hilft nur der eigene Test, individuell für seine Aufgabe. Die Benchmarks können dabei einen guten Startpunkt geben, erzählen aber nie die ganze Wahrheit. Das haben wir heute an den Sprüngen im Intelligence Index wieder gesehen.