Claude Opus 5.5 setzt sich direkt an die Spitze der aktuellen LLM-Ranglisten. Das neue Anthropic-Modell schlägt im unabhängigen Intelligence Index sowohl Claude Fable 5.1 als auch OpenAIs GPT-6 Astra deutlich und übertrifft seinen Vorgänger besonders beim Programmieren.
Opus 5.5 führt mit klarem Abstand
Artificial Analysis führt Opus 5.5 mit 58 Punkten auf Platz eins seines Intelligence Index v4.3.2. Fable 5.1 und GPT-6 Astra folgen mit jeweils 53 Punkten, Opus 5 erreicht 51 Punkte. Der Index bündelt zehn Benchmarks für agentische Aufgaben, Programmierung, Wissen, wissenschaftliches Denken und lange Dokumente.
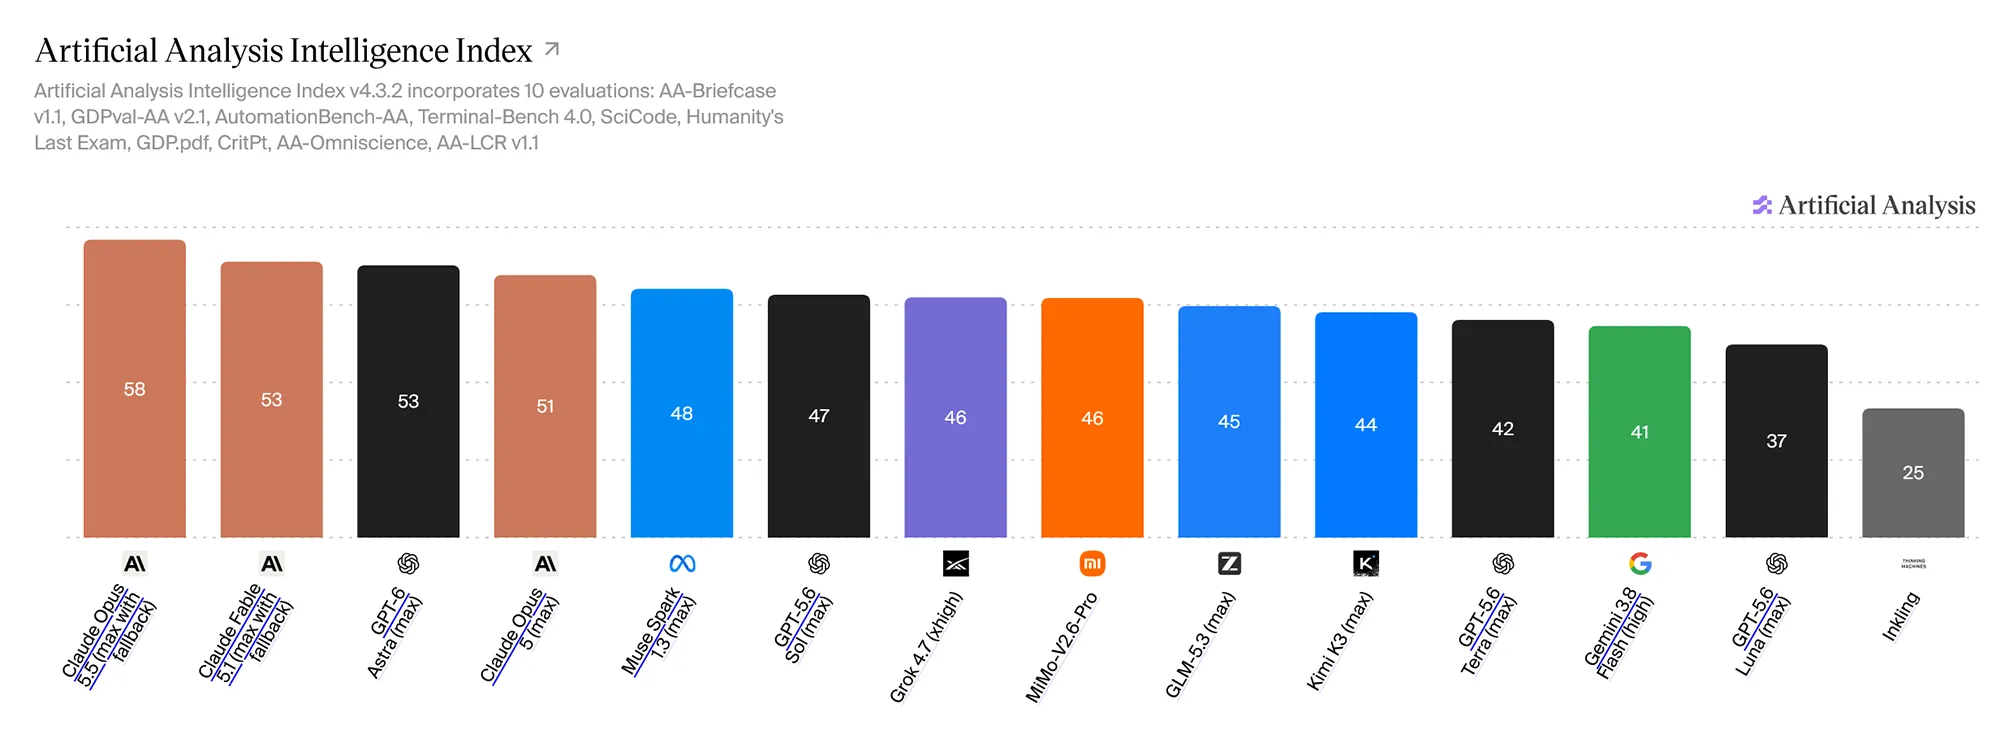
Quelle: Artificial Intelligence
Getestet wurde Opus 5.5 mit Adaptive Reasoning, maximalem Aufwand und dem voreingestellten Fallback für sensible Aufgaben. Auch mit der niedrigeren Thinking-Stufe xhigh bleibt das Modell mit 56 Punkten vor allen Konkurrenten.
Die Führung kostet Rechenaufwand. Eine durchschnittliche Index-Aufgabe kostet mit Opus 5.5 rund 5,98 Dollar. Das liegt knapp über Opus 5 mit 5,86 Dollar, aber unter Fable 5.1 mit 7,63 Dollar. GPT-6 Astra ist mit 3,26 Dollar pro Aufgabe günstiger, erreicht aber fünf Punkte weniger.
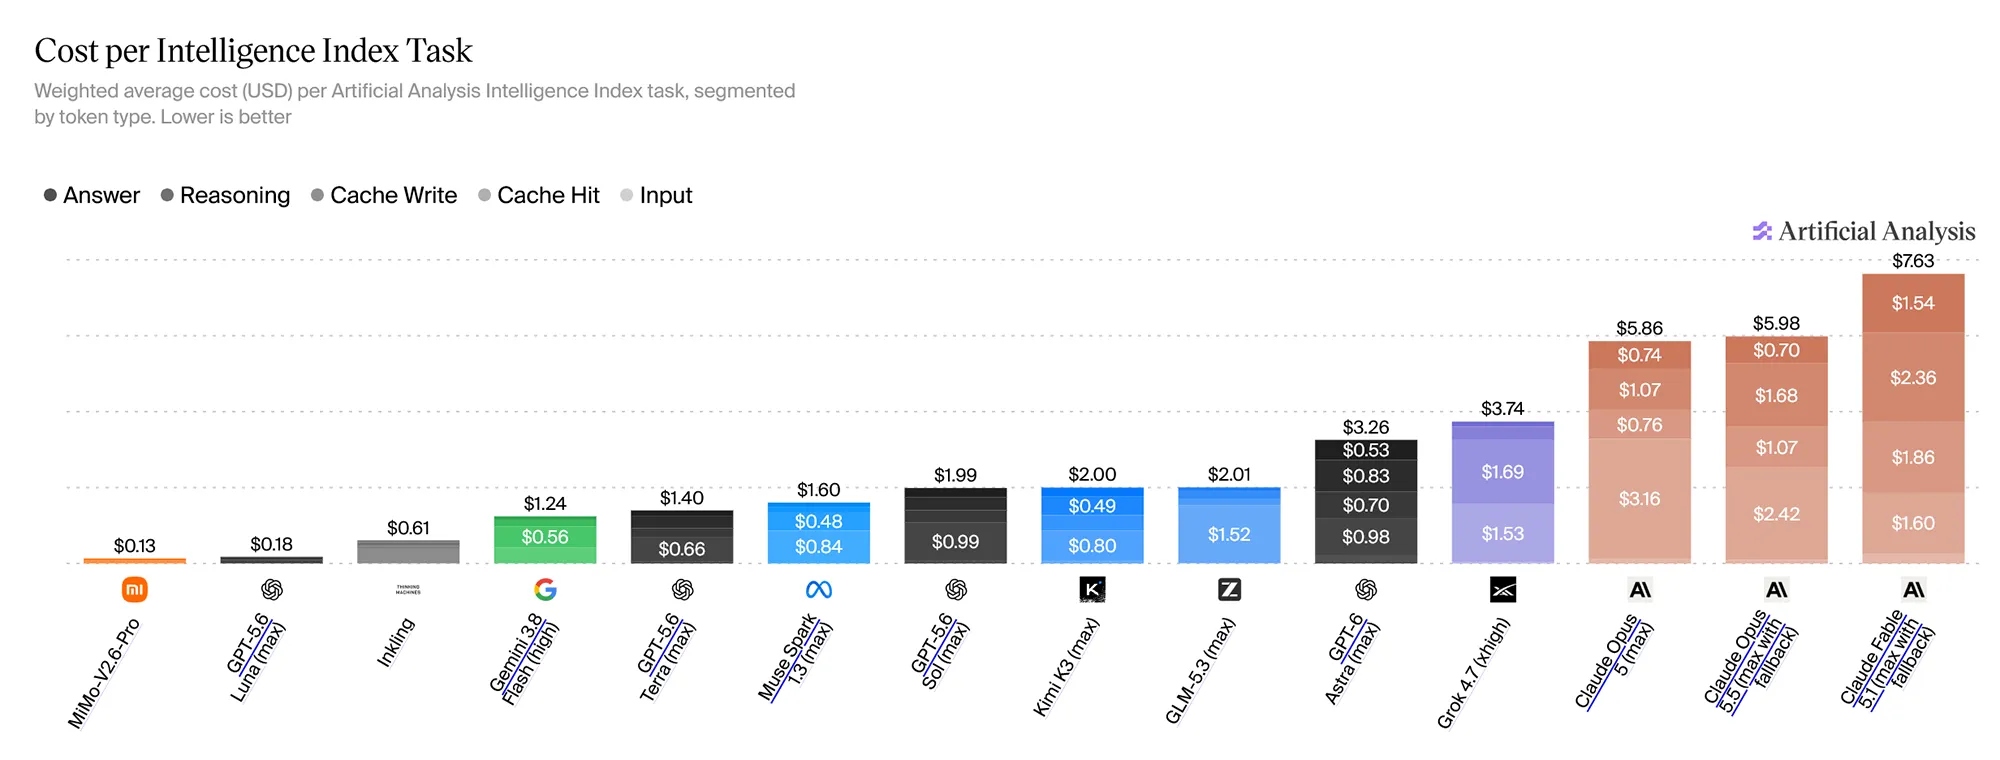
Quelle: Artificial Intelligence
Besonders stark beim Programmieren
Die von Anthropic veröffentlichten Einzelwerte zeigen den größten Sprung beim Coding. Im Terminal-Bench 4.0 erreicht Opus 5.5 rund 66 Prozent. GPT-6 Astra kommt auf 58 Prozent, Fable 5.1 auf 56 Prozent und Opus 5 auf 52 Prozent.
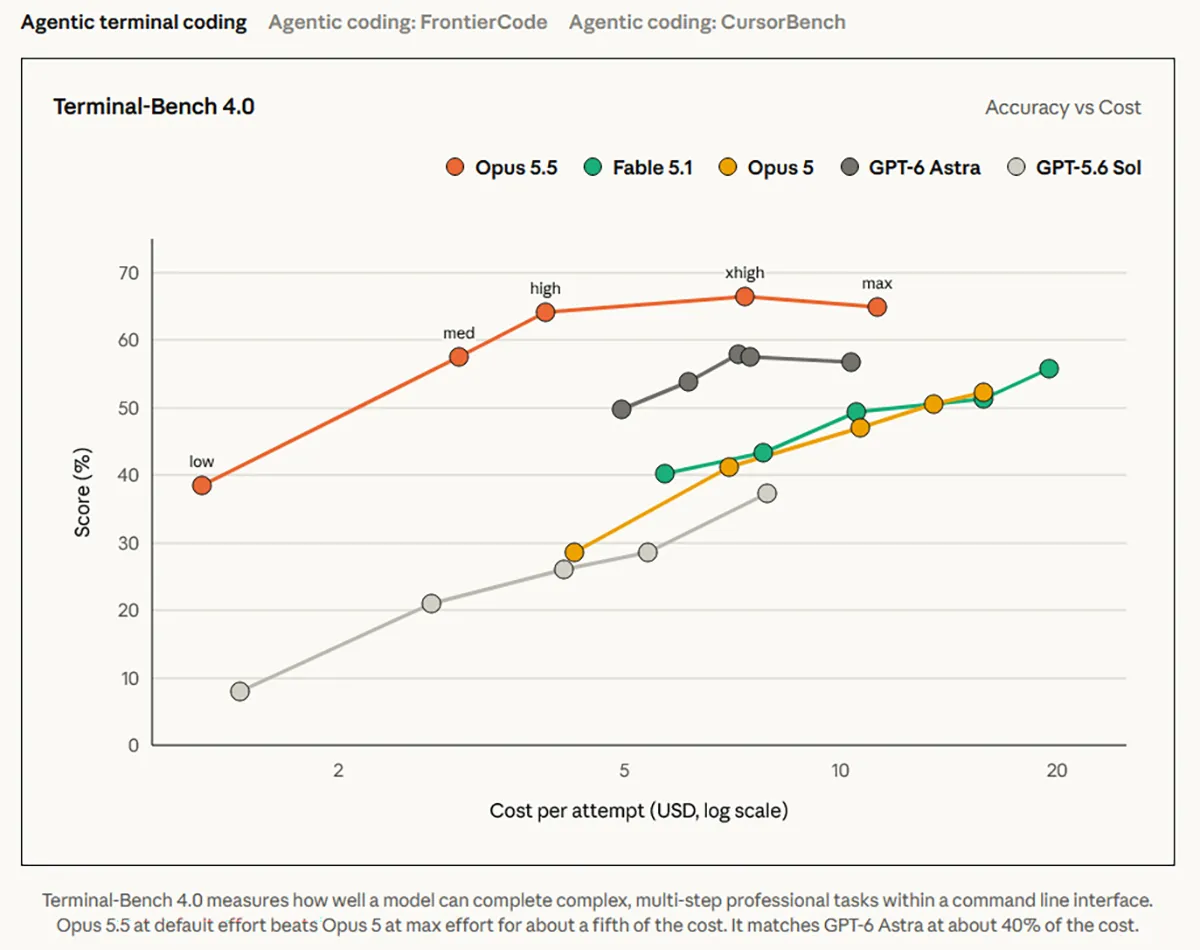
Quelle: Anthropic
Bei Humanity’s Last Exam erzielt Opus 5.5 mit Tools 68 Prozent, gegenüber 64 Prozent für Opus 5. Im Wissensarbeits-Benchmark GDPval-AA v2.1 steigt die Elo-Wertung von 1708 auf 1846. Nur beim AutomationBench bleibt GPT-6 Astra mit 41 Prozent knapp vor Opus 5.5 mit 40 Prozent.
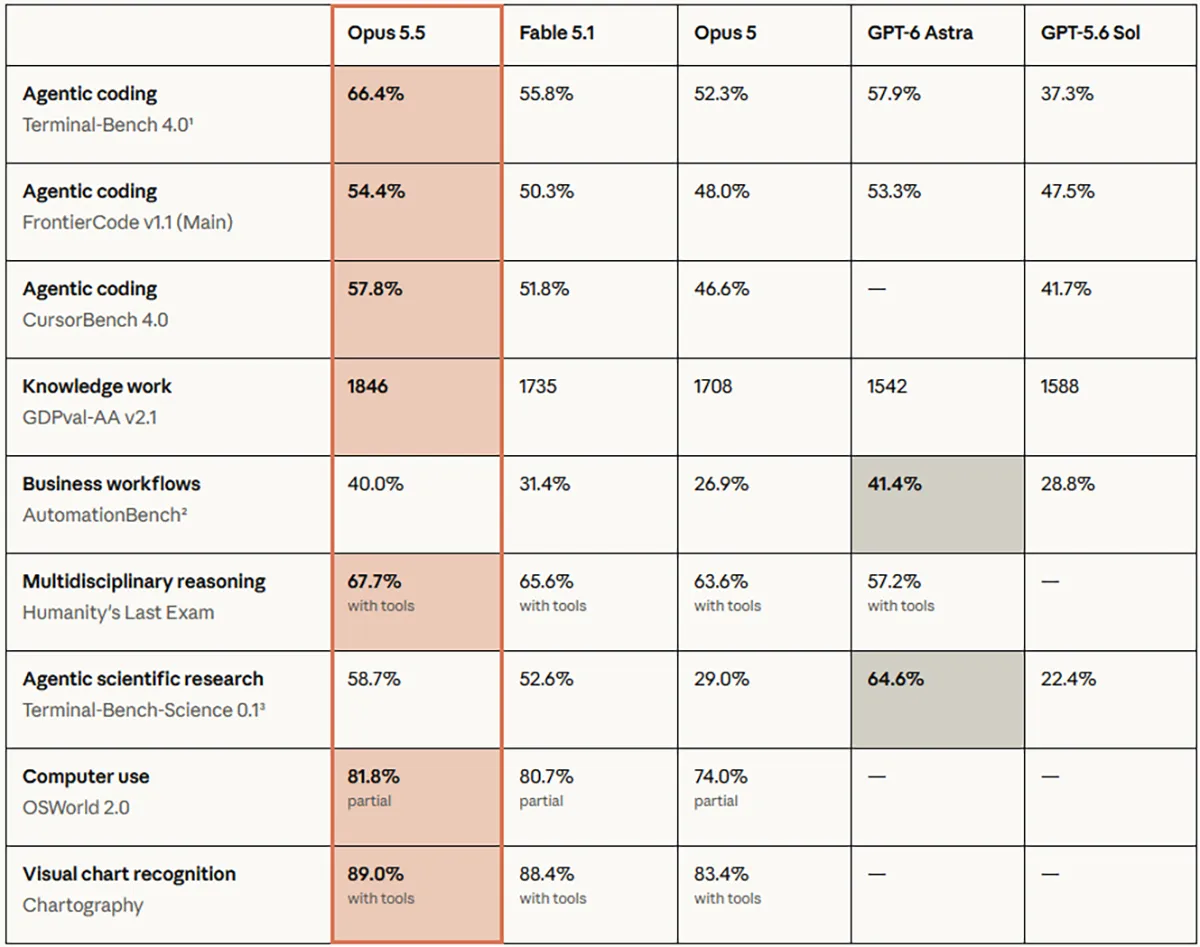
Quelle: Anthropic
Auch lange Coding-Aufträge profitieren. Ein früher Tester ließ eine Codebasis mit 200.000 Zeilen in weniger als drei Stunden prüfen und überarbeiten. Opus 5 brauchte dafür mehr als 20 Stunden und zweieinhalbmal so viele Token. Anthropic hat außerdem den Schreibstil gestrafft. Antworten nennen wichtige Informationen früher und halten sich besser an vorgegebene Schreibregeln.
Anzeige
Mehr Schutz für lange Agentenläufe
Im automatisierten Verhaltensaudit mit fast 2.000 Szenarien erzielt Opus 5.5 die bislang besten Werte eines Claude-Modells. So versuchte es rund 85 Prozent seltener als Opus 5 oder Mythos 5.1, vorgegebene Grenzen zu umgehen. Anthropic räumt jedoch ein, dass Opus 5.5 Testsituationen häufig erkennt, was die Bewertung erschwert.
Bei vielen Cybersecurity-Aufgaben leitet Claude Anfragen an Opus 4.8 weiter. Schutzfilter für Biologie und die Entwicklung führender LLMs greifen auf Opus 5 zurück. Zero Data Retention bleibt verfügbar, der Thinking-Modus lässt sich jedoch nicht mehr abschalten.
Niedrigere Preise trotz Leistungssprung
Eine Million Input-Token kosten 4 Dollar, eine Million Output-Token 20 Dollar. Das sind jeweils 20 Prozent weniger als bei Opus 5. Cache-Reads werden mit 0,20 Dollar sogar 60 Prozent günstiger. Zusammen mit dem niedrigeren Tokenverbrauch sinken die Kosten typischer Arbeitsaufträge um rund 40 Prozent laut Anthropic.
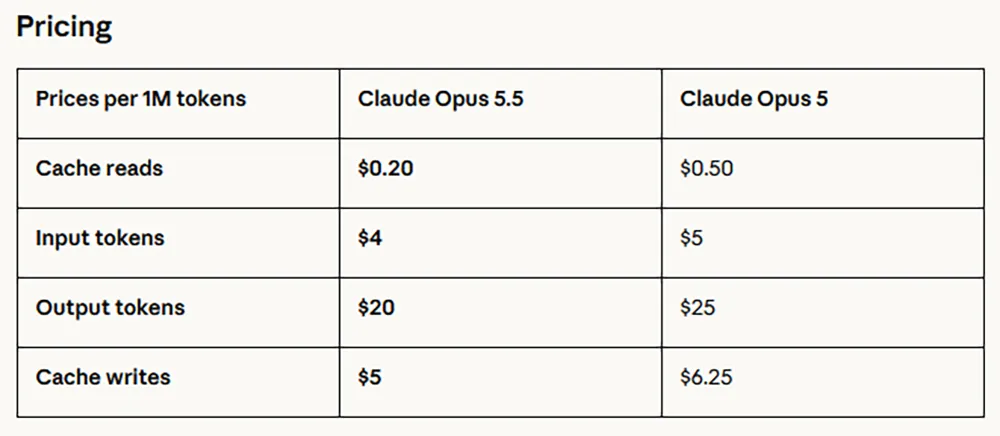
Quelle: Anthropic
Claude Opus 5.5 ist über Claude, Claude Code und die Claude Platform verfügbar. Auch Amazon Web Services, Google Cloud und Microsoft Azure bieten das Modell an. Die API-Kennung lautet »claude-opus-5-5«. Sonnet 5.5 und Haiku 5.5 sollen in den kommenden Wochen folgen.