Anthropic bringt dasselbe KI-Modell wie bisher unter zwei Namen heraus. Claude Fable 5.2 kommt mit Schutzfiltern für IT-Sicherheit und Biologie in die Claude-Apps, während geprüfte Organisationen Claude Mythos 5.2 mit weniger Einschränkungen bekommen.
Anzeige
Fable 5.2 alleine auf Rang 1
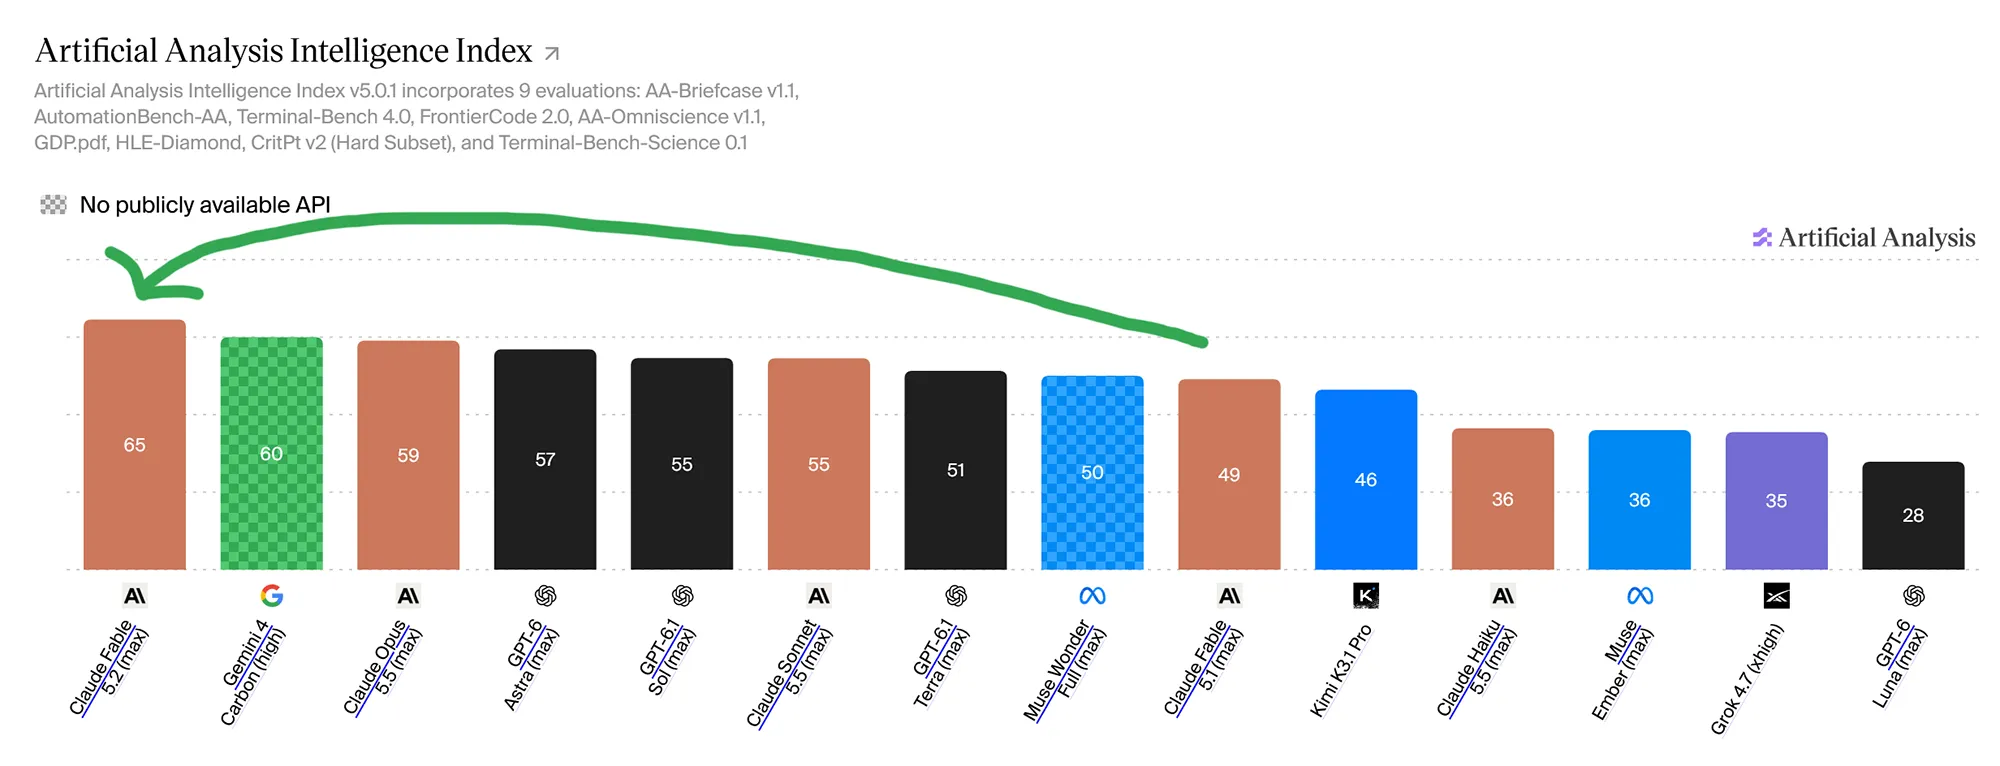
Claude Fable 5.1 führte bei seinem Start den Intelligence Index von Artificial Analysis an. In der aktuellen Rangliste liegt es mit 49 Punkten deutlich hinter Opus 5.5 mit 59 Punkten und kostet pro Eingabe- und Ausgabe-Token jeweils das Zweieinhalbfache. Fable 5.2 holt die Führung zurück und setzt sich mit 65 Punkten deutlich vor Gemini 4 Carbon und Opus 5.5.
Quelle: Artificial Analysis
Fable 5.2 schlägt GPT-6 Astra beim Programmieren
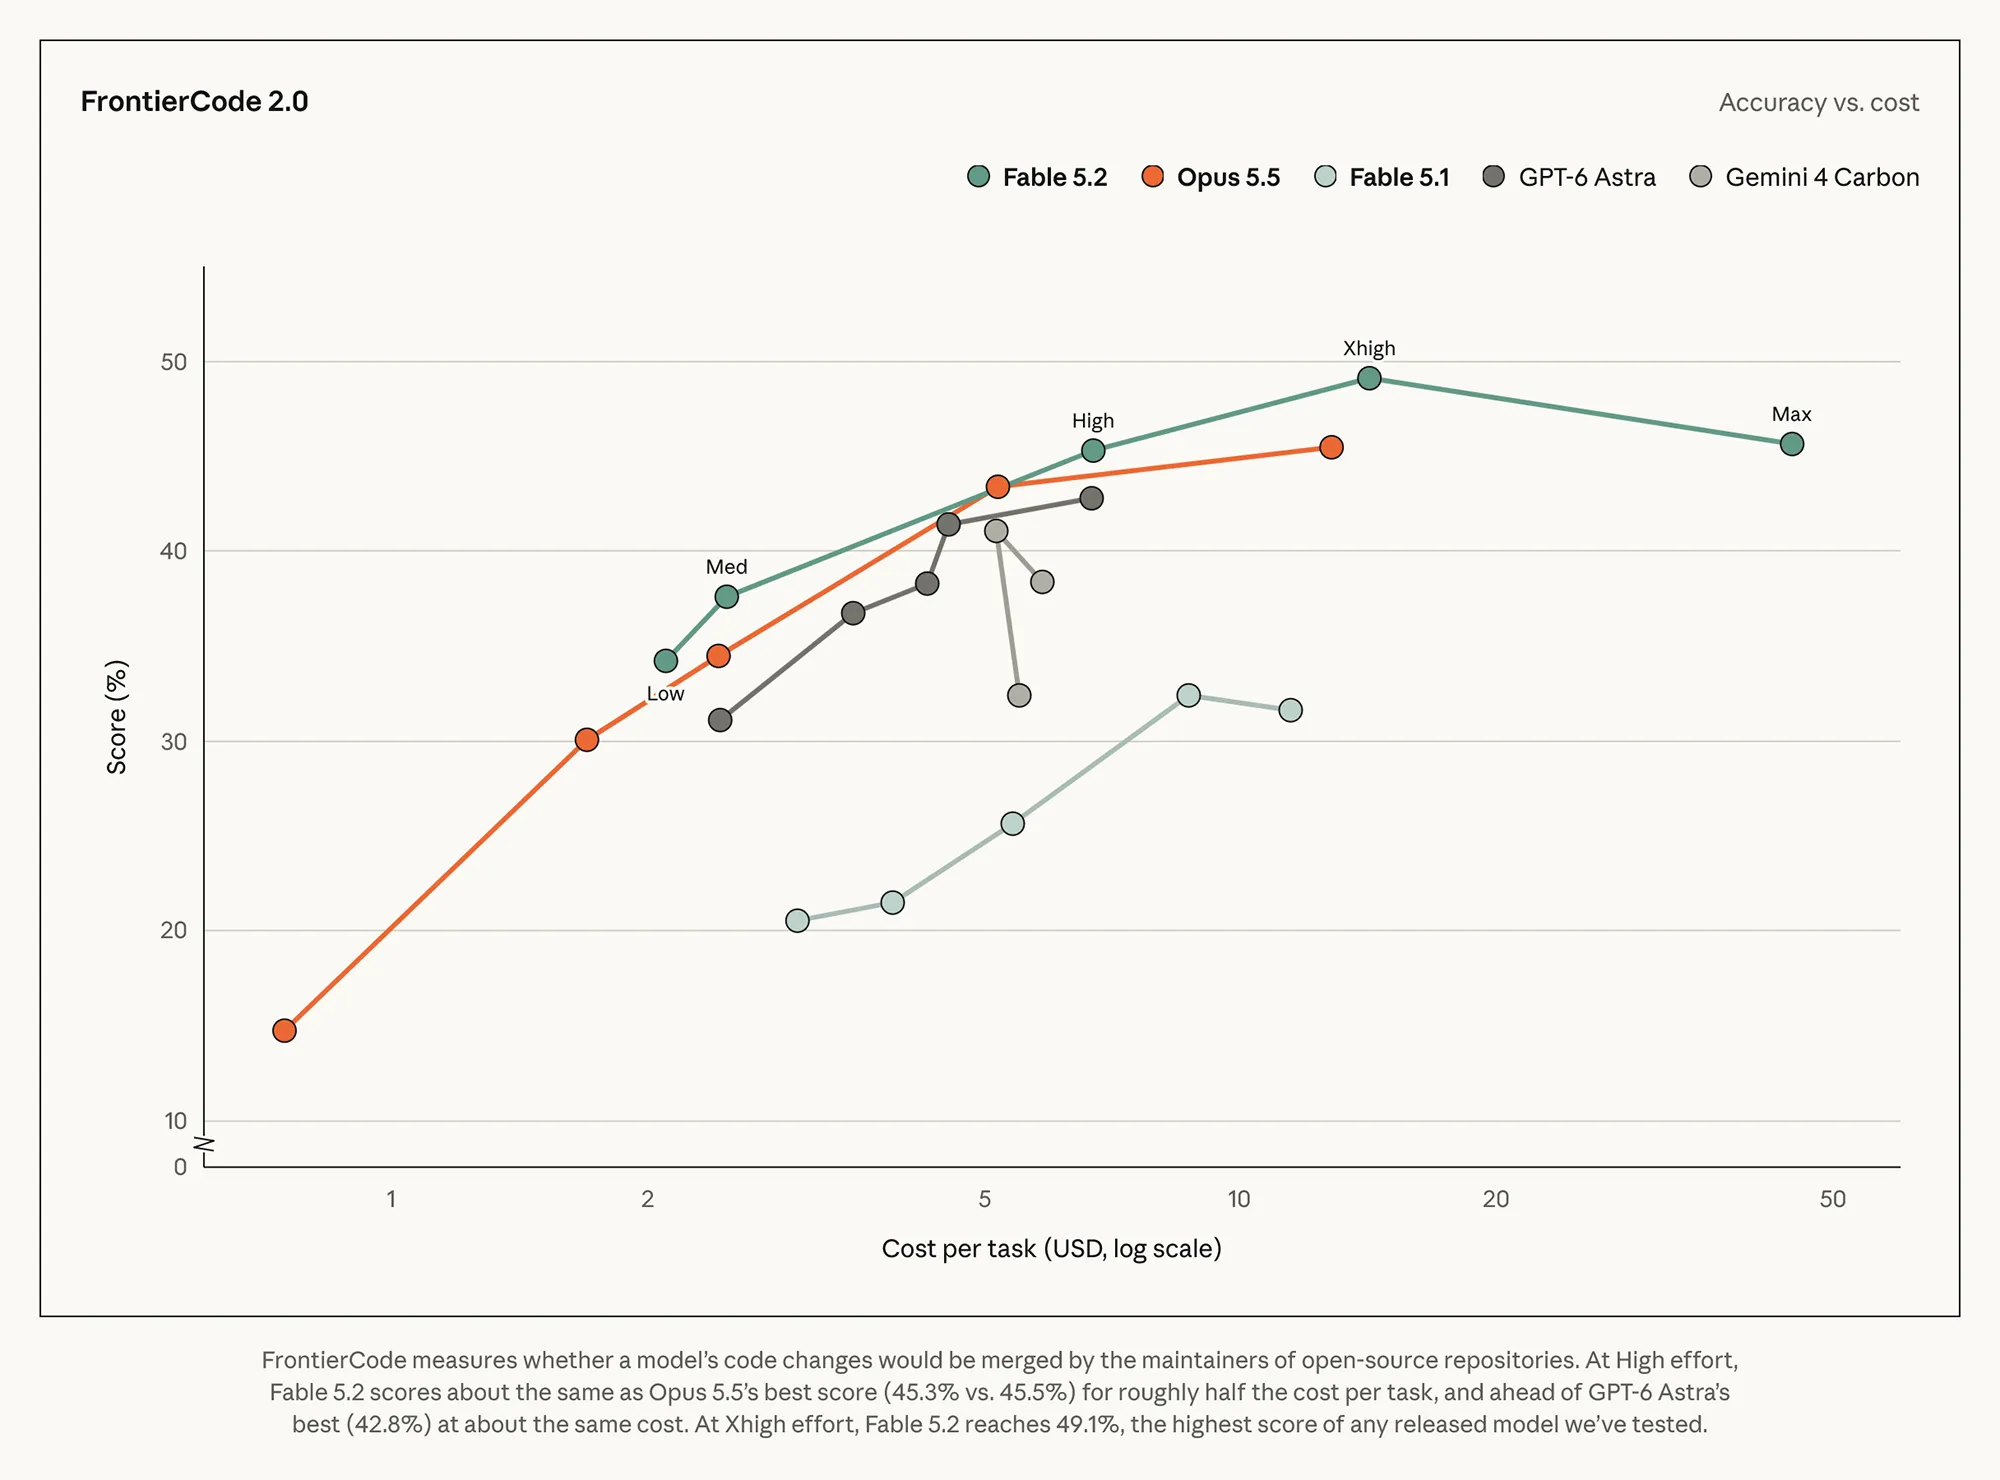
FrontierCode 2.0 prüft, ob Projektbetreuer vorgeschlagene Codeänderungen in ihre Open-Source-Projekte übernehmen würden. Fable 5.2 erreicht auf der Thinking-Stufe »Xhigh« 49,1%, vor Opus 5.5 mit 45,5% und GPT-6 Astra mit 42,8%. Auf »High« kommt Fable schon fast an den Bestwert von Opus heran und kostet dabei ungefähr halb so viel pro Aufgabe.
Quelle: Anthropic
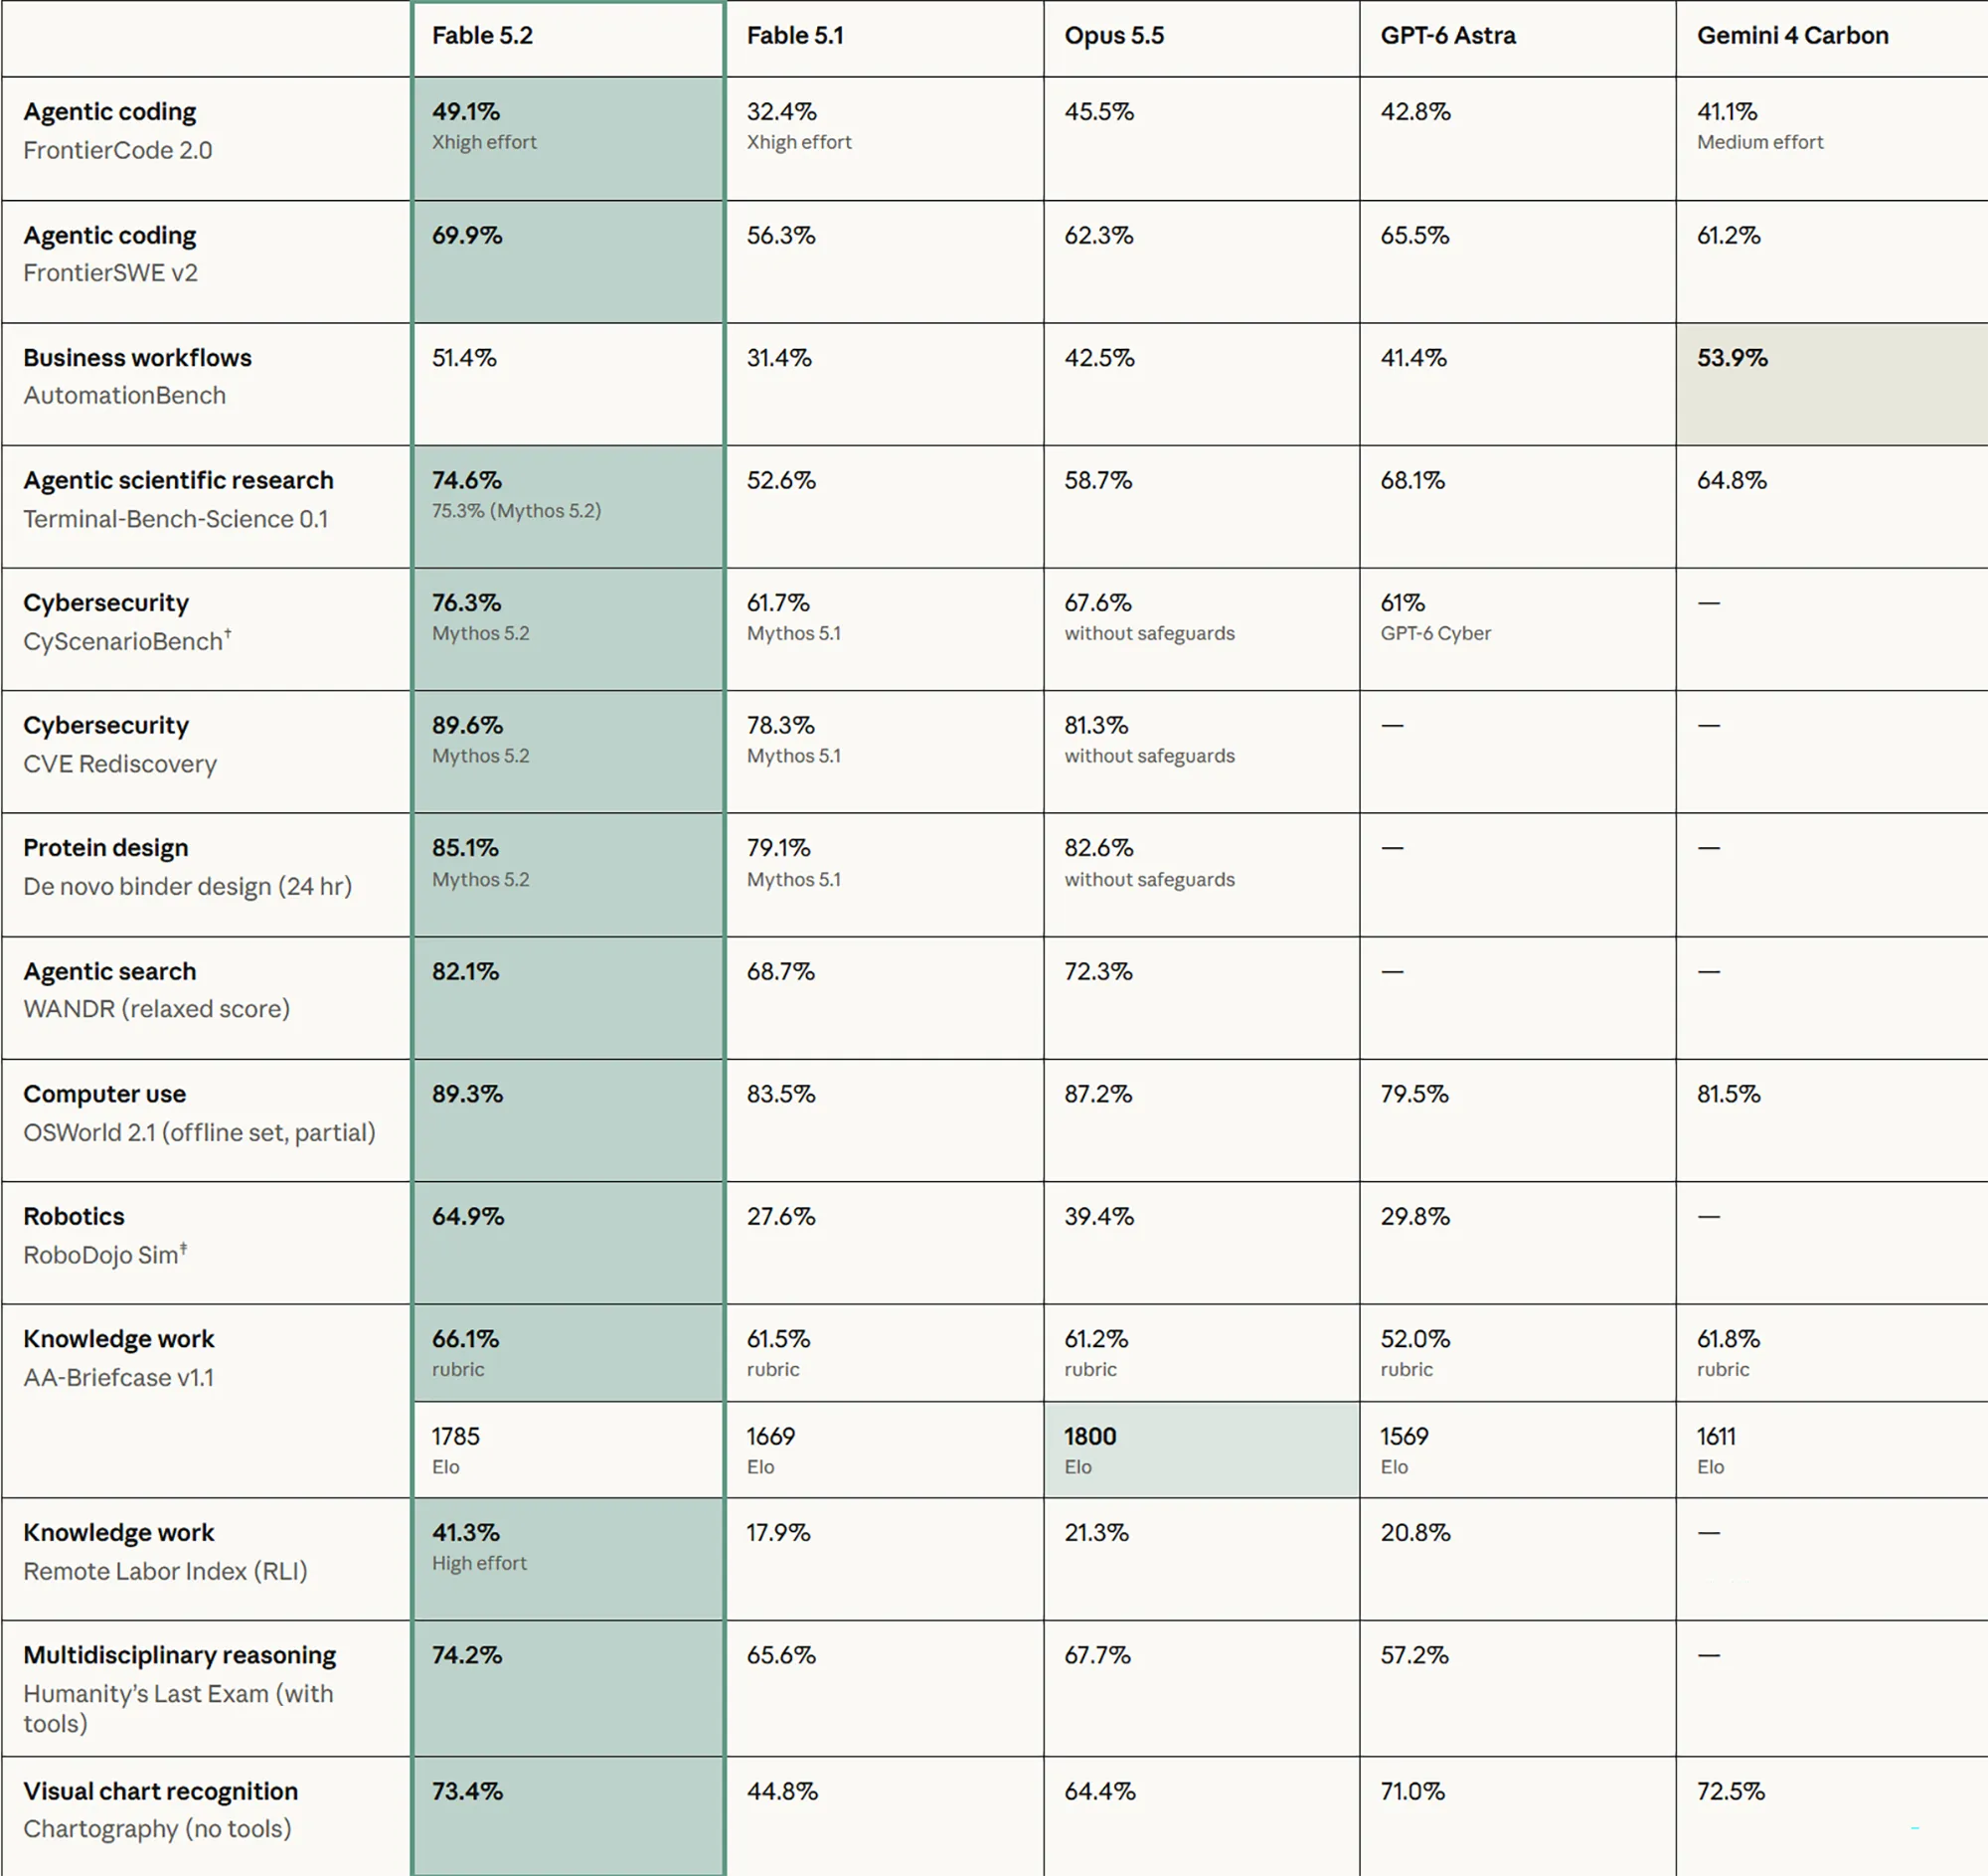
Bei den fachübergreifenden Fragen von Humanity’s Last Exam erreicht Fable 5.2 mit Tools 74%, GPT-6 Astra 57%. Bei umfangreichen Arbeitsaufträgen in AA-Briefcase führt Fable mit 66%. Bei automatisierten Geschäftsabläufen in AutomationBench hat Googles Gemini 4 Carbon mit 54% gegenüber 51% die Nase vorn. Das ist aber die absolute Ausnahme.
Quelle: Anthropic
Tausend Agenten, 30 Stunden und Fermats letzter Satz
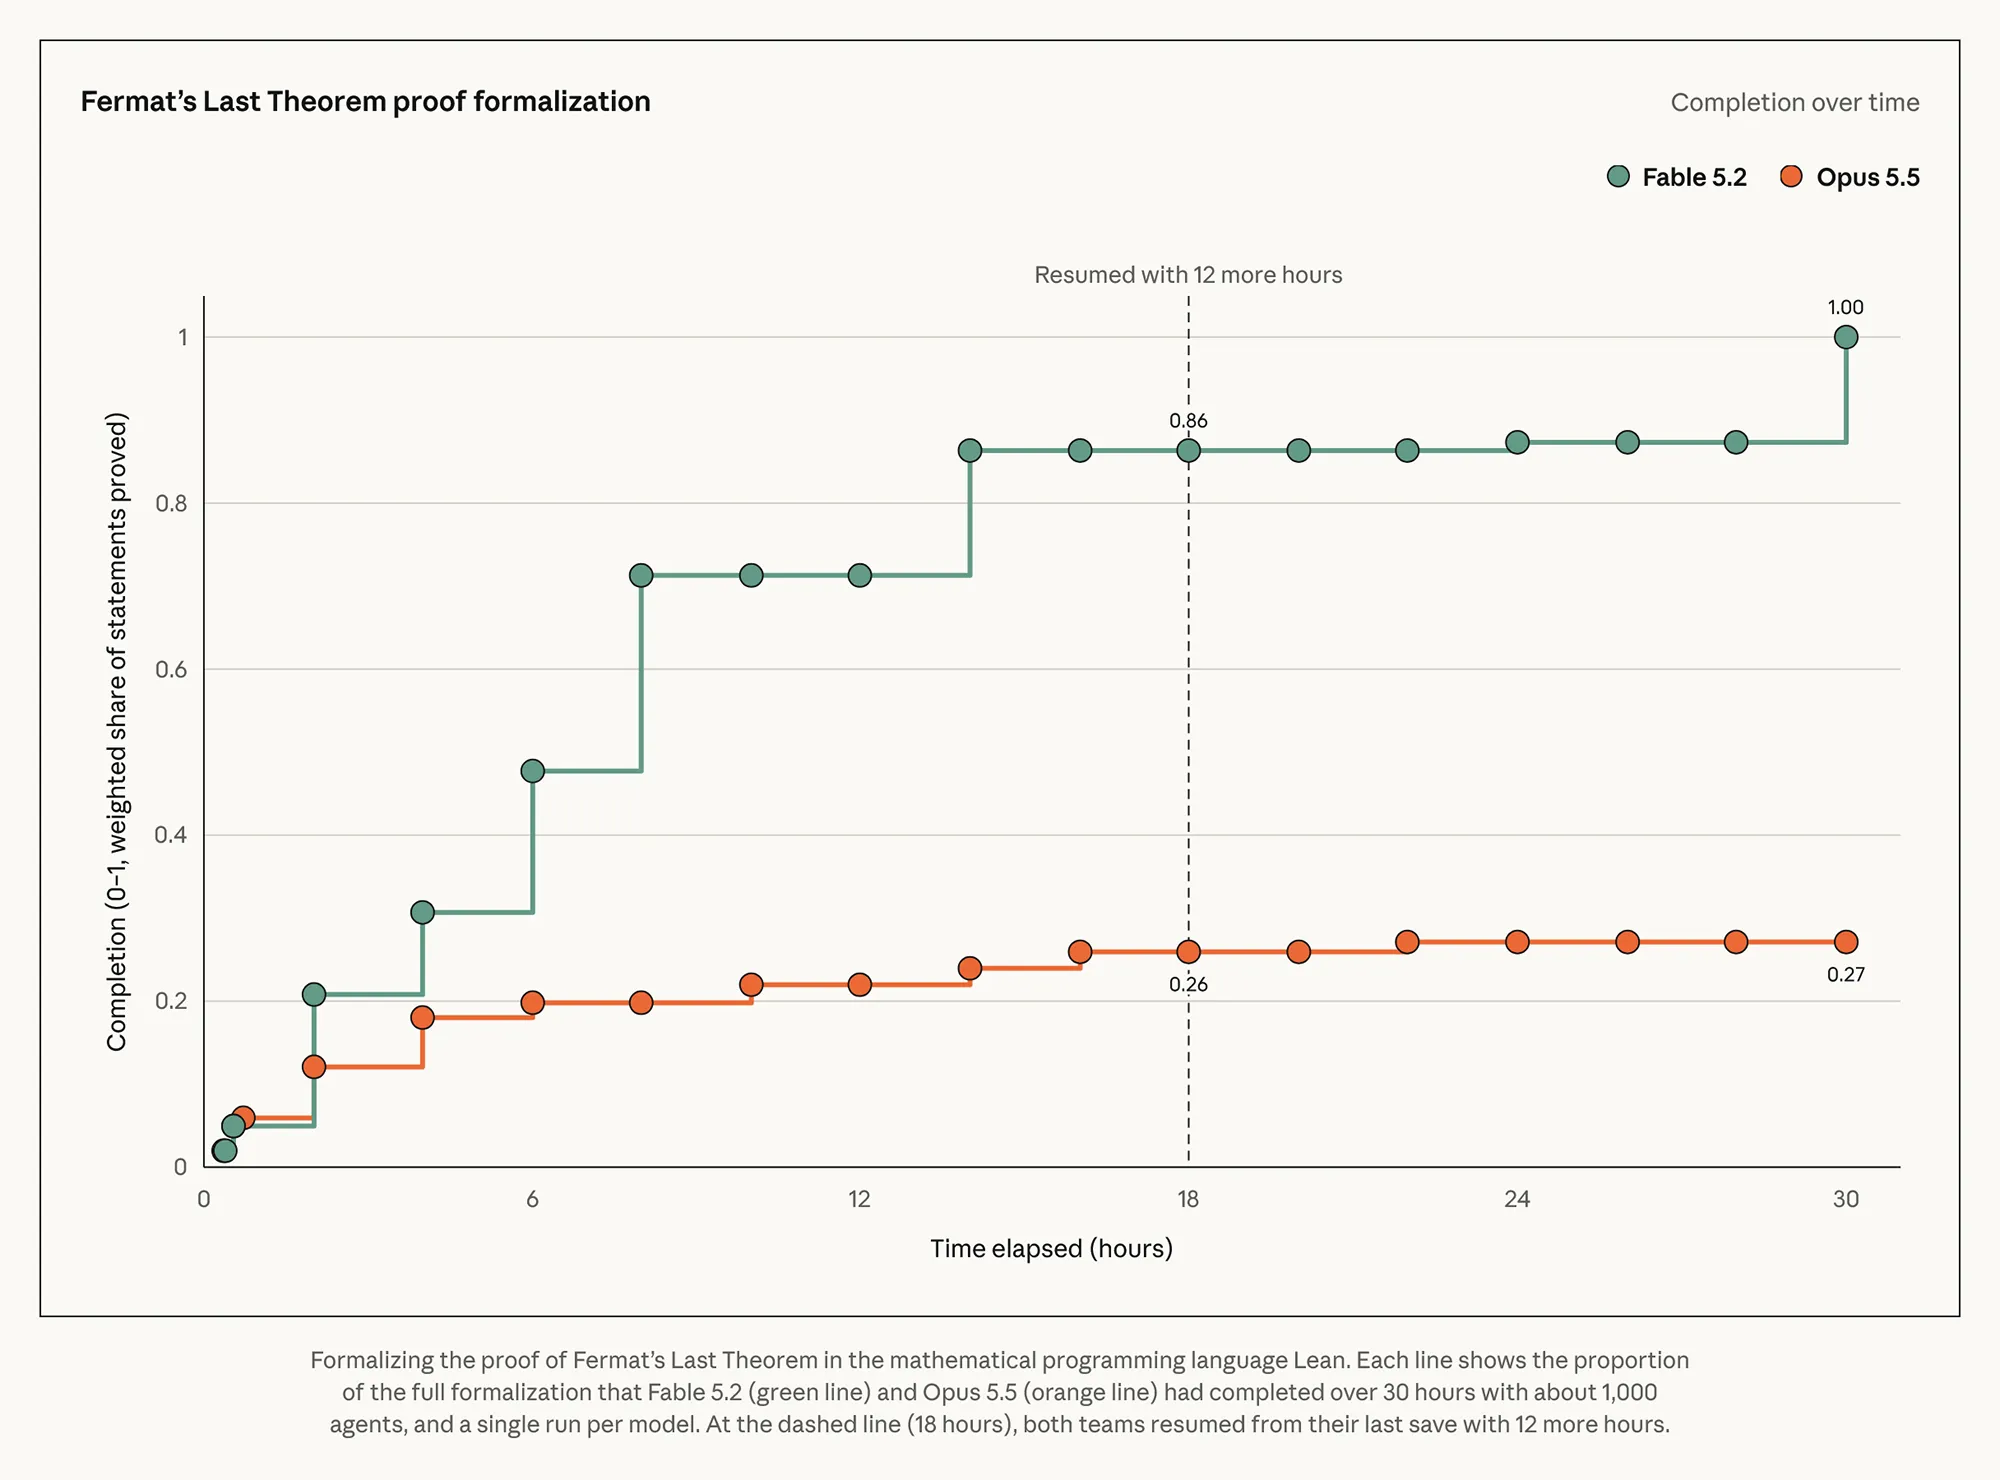
Rund 1.000 Agenten mit Fable 5.2 brauchten in einem Versuch 30 Stunden, um den bekannten Beweis von Fermats letztem Satz so in die Sprache Lean zu übertragen, dass ihn ein Computer Schritt für Schritt prüfen kann. Ein gleich großes Team mit Opus 5.5 kam in derselben Zeit nur auf 27%. Ein internes Forschungsmodell von Anthropic hatte für eine frühere Fassung noch elf Tage gebraucht.
Quelle: Anthropic
Mythos 5.2 findet neun von zehn Sicherheitslücken wieder
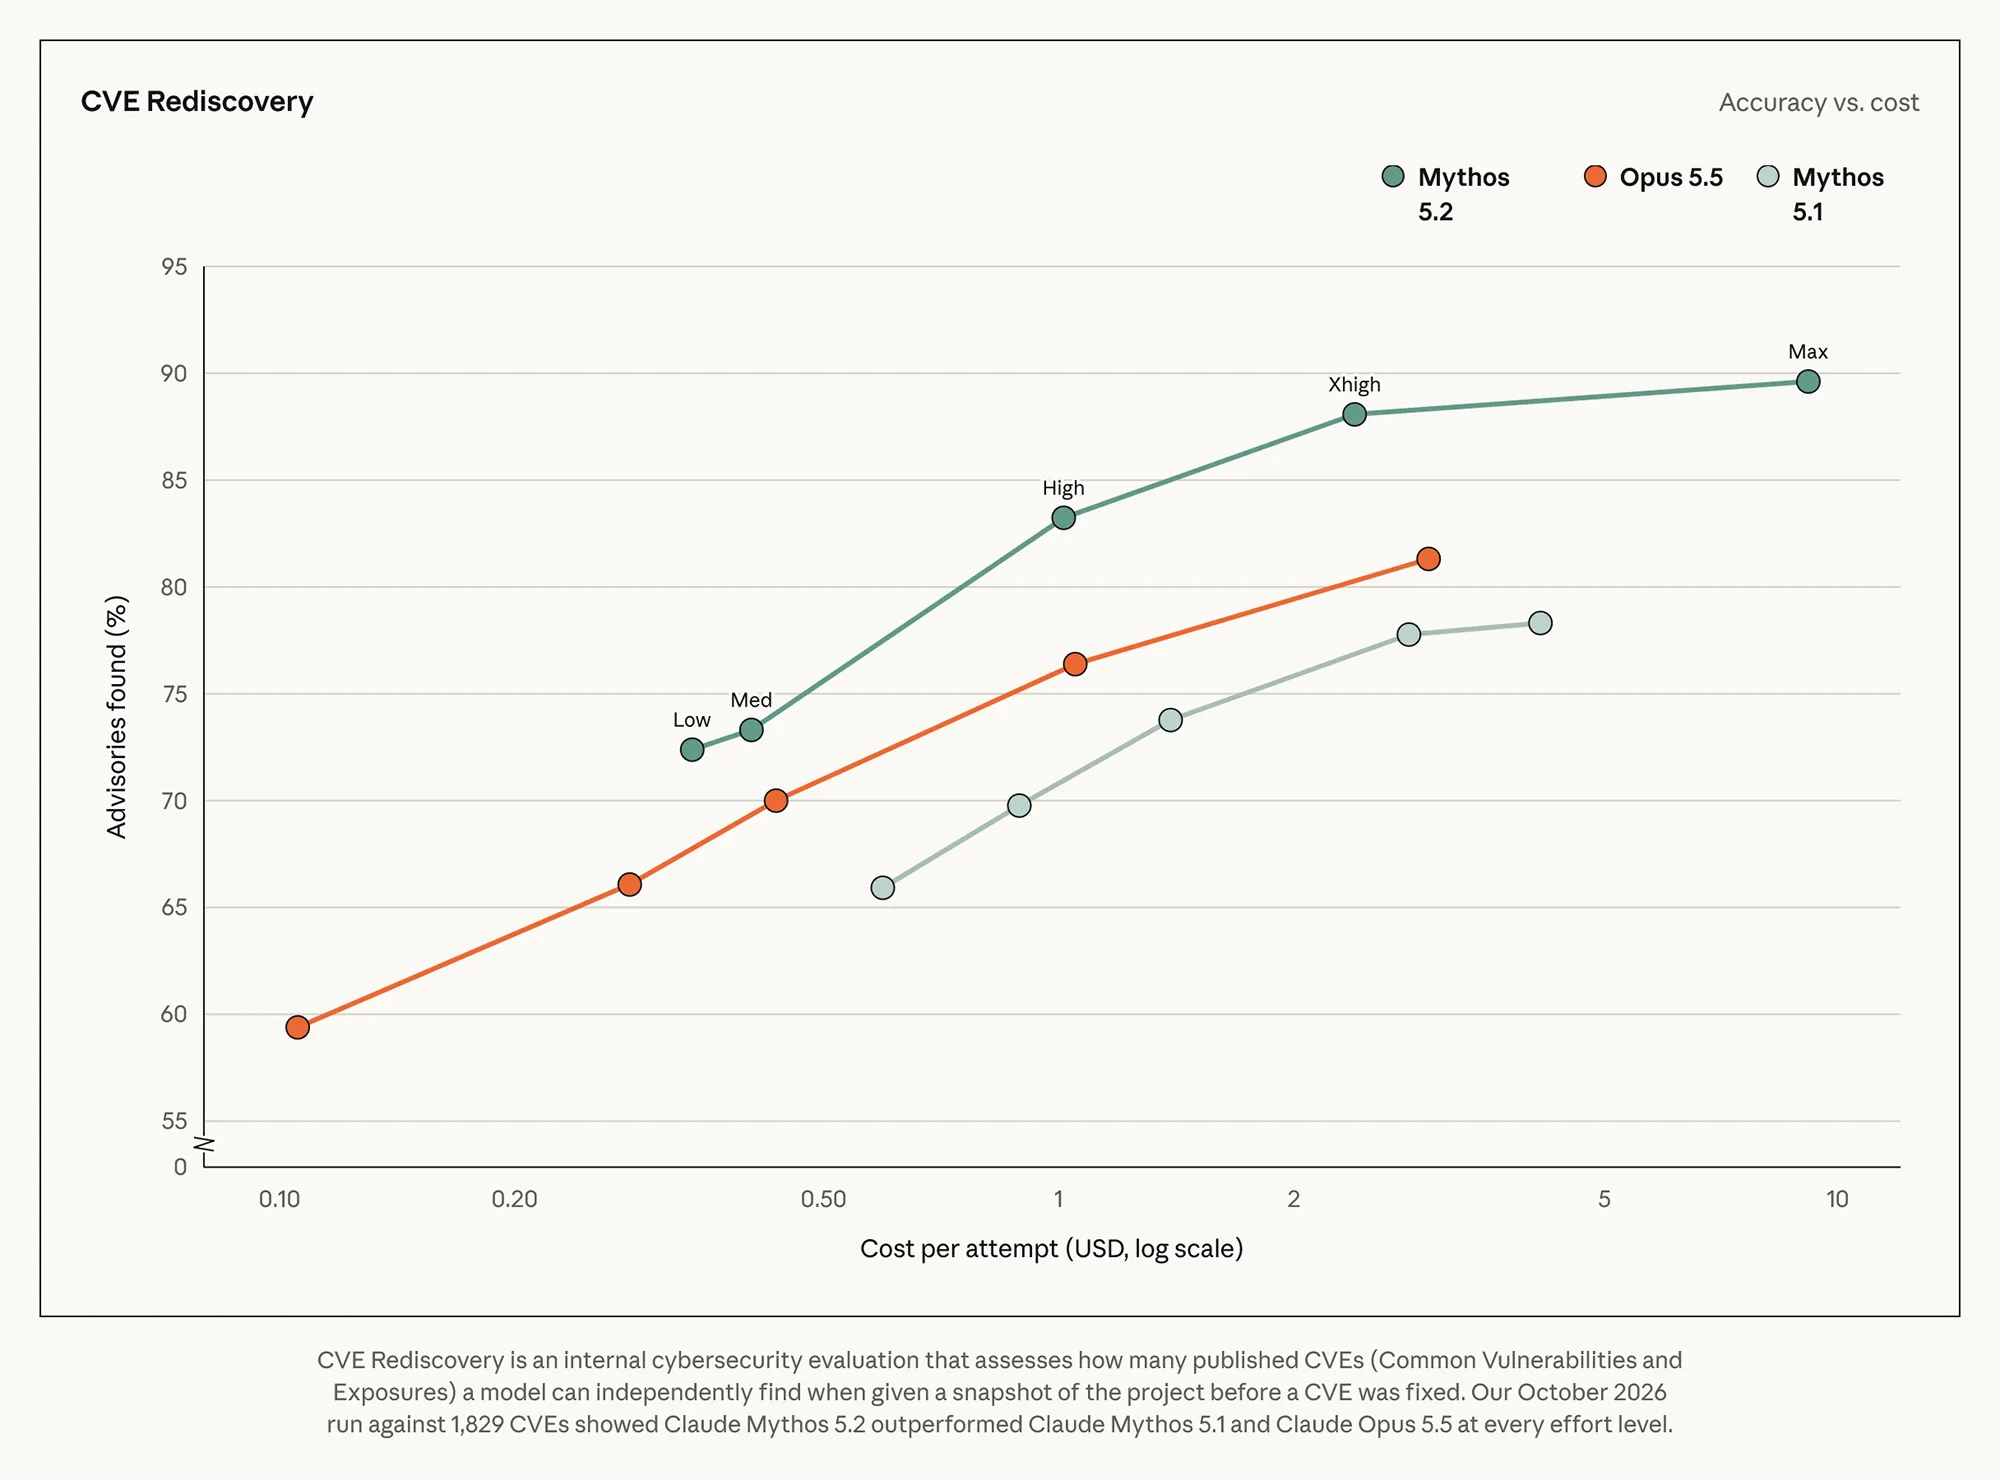
In Anthropics internem Test fand Mythos 5.2 rund 90% von 1.829 bereits dokumentierten Schwachstellen im Code wieder. Der Vorgänger kam auf 78%. Bei Fable 5.2 greifen Schutzfilter etwa bei Anfragen zu Penetrationstests oder zur Entwicklung von Exploits. Gegenüber Fable 5.1 registrierte Anthropic in frühen Tests insgesamt rund 55% weniger Sperren bei Anfragen zu IT-Sicherheit und Biologie.
Quelle: Anthropic
Was Fable und Mythos 5.2 kosten und wer Zugang bekommt
Fable 5.2 startet in Claude, Claude Code und über die API sowie bei AWS, Google Cloud und Microsoft Azure. Für beide Varianten nennt Anthropic API-Preise von 8$ pro Million Eingabe-Token und 40$ pro Million Ausgabe-Token. Bei Fable sinken die Standardpreise damit um jeweils 20% gegenüber Version 5.1. Der optionale Schnellmodus kostet das Doppelte und erzeugt laut Anthropic bis zu 2,5-mal so viele Token pro Sekunde.
Für den direkten Zugriff auf Mythos 5.2 müssen sich Organisationen über Anthropics Prüfprogramme für IT-Sicherheit oder Biowissenschaften bewerben. Kunden von Claude Enterprise können ihre Codebestände auch über Claude Security mit Mythos 5.2 auf Schwachstellen prüfen lassen.
Anzeige