Google überrascht mit Gemini 4 Argon die Spitzenmodelle von Anthropic und OpenAI. Das neue LLM führt in mehreren Tests für Wissensarbeit, Programmierung und Agenten mit teils gewaltigem Abstand und bewältigt besonders lange Aufgaben in einem Durchgang. Und das zu einem unglaublichen Preis!
EDIT: Wir haben unten unabhängige Benchmarks von Artificial Intelligence hinzugefügt.
Quelle: Google
Argon dominiert bei Arbeit und Agenten
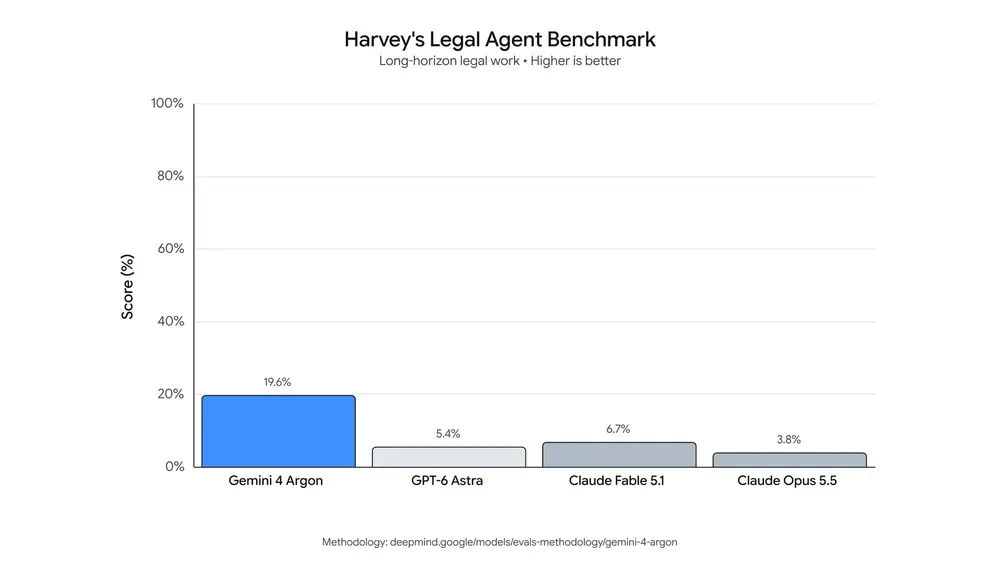
Am deutlichsten fällt der Vorsprung im Harvey’s Legal Agent Benchmark aus. Gemini 4 Argon erreicht dort 20 Prozent, GPT-6 Astra kommt auf 5 Prozent, Claude Fable 5.1 auf 7 Prozent und Claude Opus 5.5 auf 4 Prozent. Der Test prüft juristische Recherche und das Verfassen entsprechender Texte.
Quelle: Google
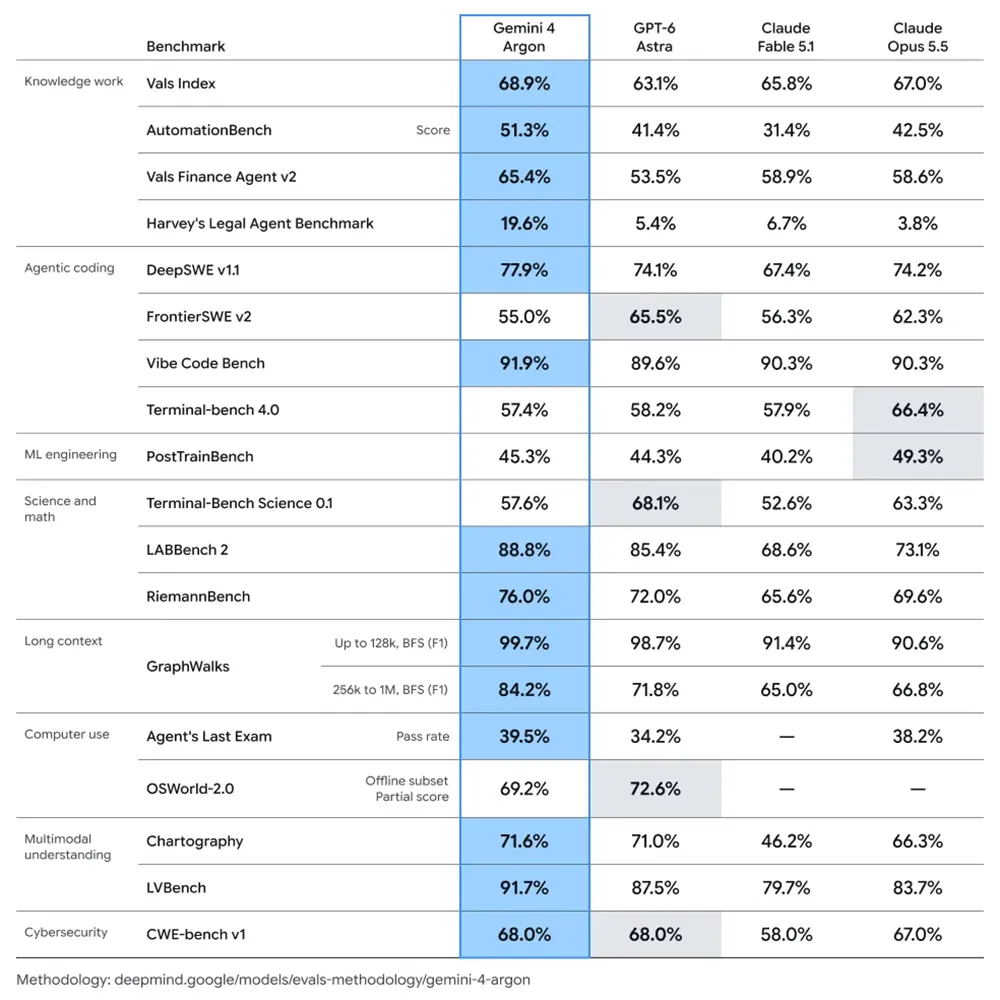
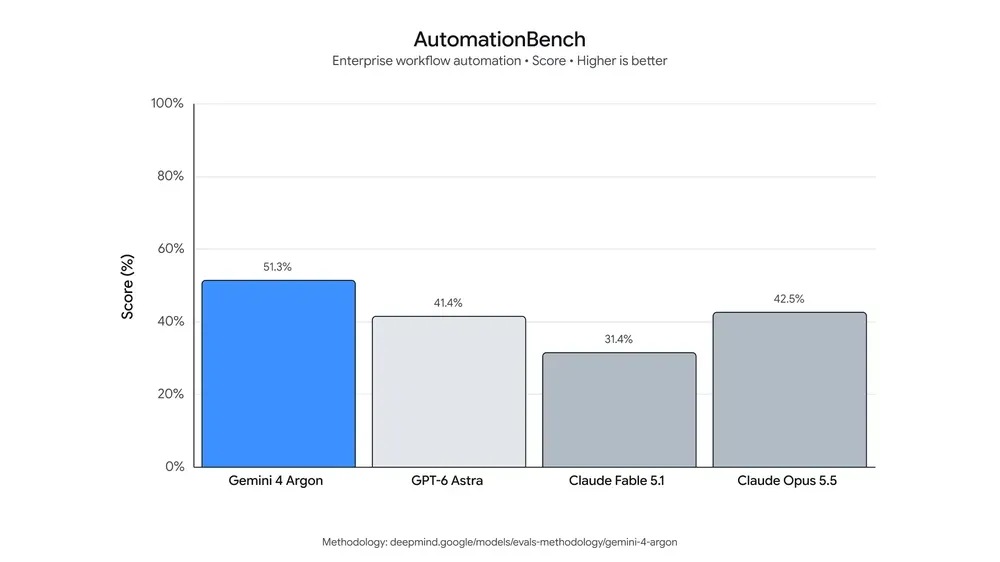
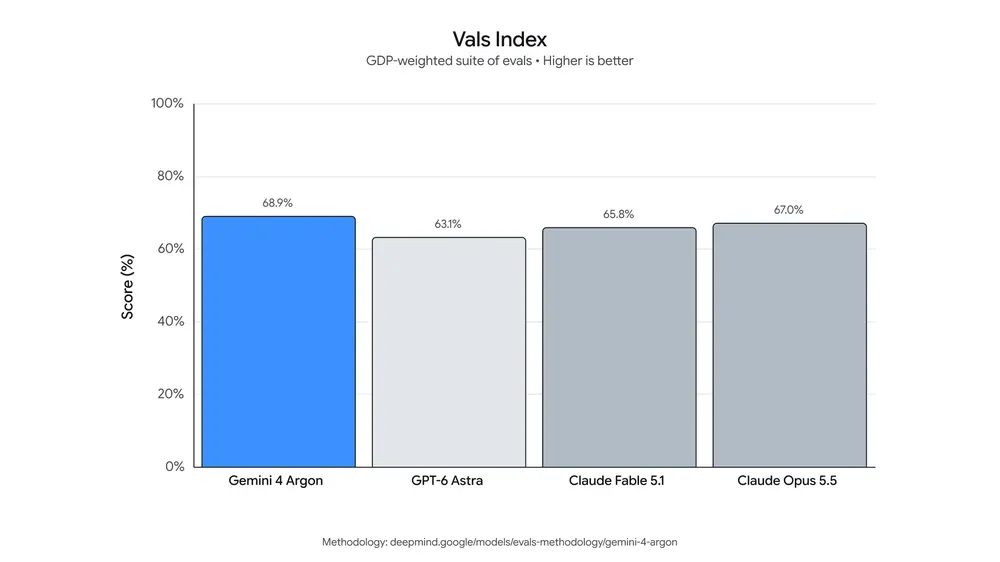
Auch im AutomationBench für vollständige Arbeitsabläufe liegt Argon mit 51 Prozent vorn. Claude Opus 5.5 erreicht 43 Prozent, GPT-6 Astra 41 Prozent und Claude Fable 5.1 lediglich 31 Prozent. Beim breiter angelegten Vals Index für wirtschaftlich relevante Wissensarbeit wird das Rennen enger. Google erzielt 69 Prozent vor Claude Opus 5.5 mit 67 Prozent.
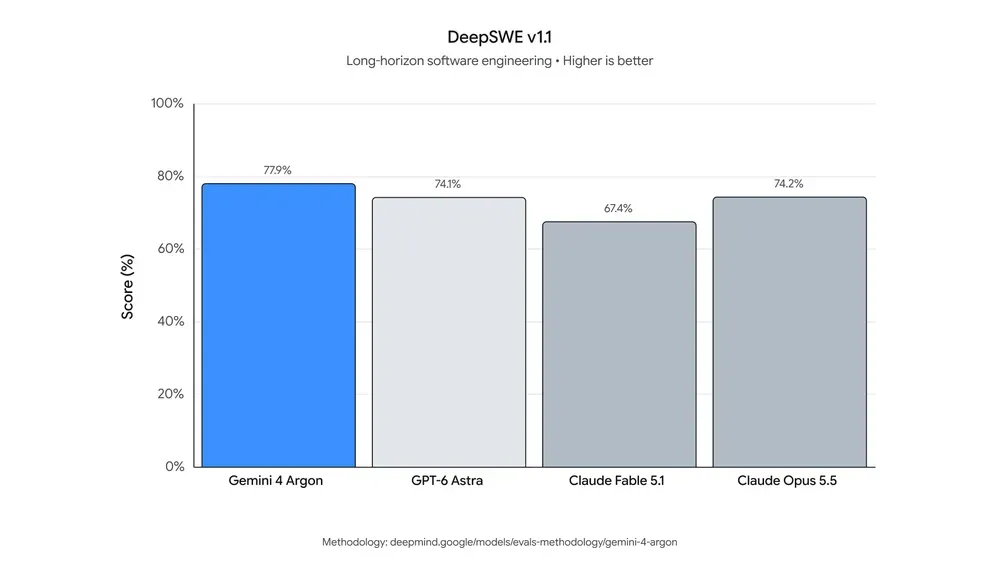
Bei langen Programmieraufgaben setzt Argon im DeepSWE v1.1 mit 78 Prozent einen neuen Bestwert. GPT-6 Astra und Claude Opus 5.5 liegen jeweils bei rund 74 Prozent. Einen vollständigen Durchmarsch schafft Google allerdings nicht. Im FrontierSWE v2 und Terminal-Bench 4.0 bleiben die Konkurrenten ganz knapp vorn.
Quelle: Google
Für wissenschaftliche Aufgaben liefert LABBench 2 ein weiteres starkes Ergebnis. Argon erreicht 89 Prozent und übertrifft GPT-6 Astra um 4 Prozentpunkte. Beim mathematischen RiemannBench führt das Modell mit 76 Prozent ebenfalls das Feld an.
Anzeige
Eine Million Token für lange Aufgaben
Google hebt zudem das Ausgabelimit von 64.000 auf eine Million Token an. Dies darf nicht mit dem Kontext-Fenster verwechselt werden. Gemini 4 kann also nicht nur sehr viel Kontext aufnehmen, sondern jetzt als erstes Modell auch am Stück 1 Million Token ausgeben. Mit einem Klick könnte Gemini so z. B. 20 große Bücher schreiben, ohne jegliche Unterbrechung.
Argon kann damit lange Arbeitsabläufe verfolgen und umfangreiche Ergebnisse in einem einzigen Lauf erzeugen. Beim Langkontext-Test GraphWalk verarbeitet es selbst Aufgaben im Bereich von 256.000 bis einer Million Token deutlich besser als die Vergleichsmodelle.
Intern setzt Google Argon bereits für große Softwareprojekte ein. Agenten migrieren C- und C++-Code nach Rust, darunter mehr als 800.000 Zeilen des Zircon-Kernels von Fuchsia. Beim Videodecoder libgav1 ersetzten sie 32.000 Zeilen SIMD-Code. Der neue Rust-Code läuft 2,7-mal schneller als der vorherige Port.
Cybersecurity wird zur Paradedisziplin
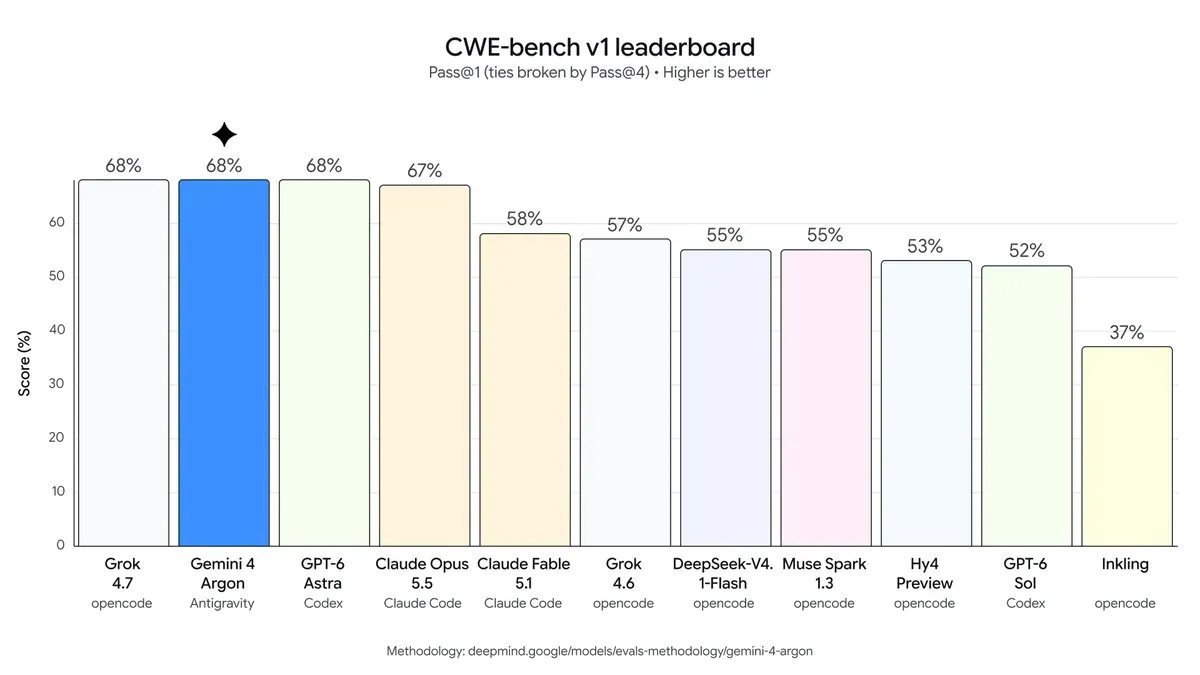
Argon findet, bestätigt und repariert Schwachstellen selbstständig. Im CWE-bench v1 erreicht es 68 Prozent und teilt sich den ersten Platz mit GPT-6 Astra und Grok 4.7. Bei Googles internem Test zur Schwachstellensuche steigt die Trefferquote gegenüber Gemini 3.8 Flash Cyber von 71 auf 86 Prozent.
Quelle: Google
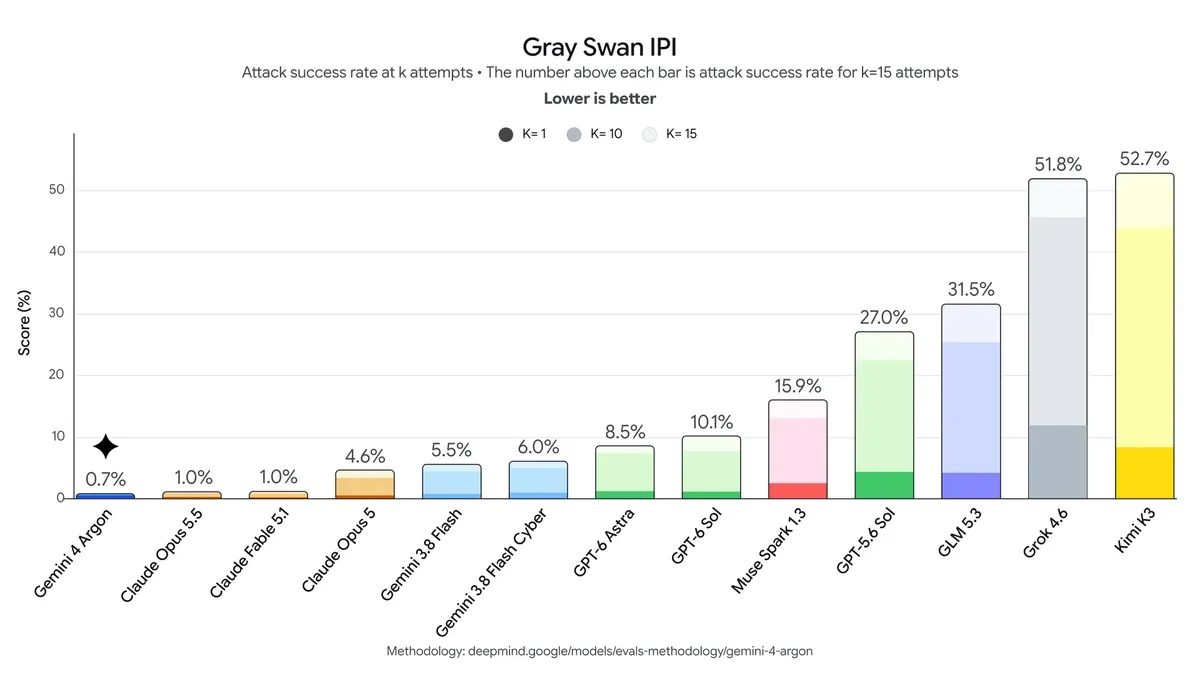
Gegen indirekte Prompt-Injections erzielt Argon im Gray-Swan-Test mit 0,7 Prozent die niedrigste Quote für Angreifer. Google stattet das Modell außerdem mit einer Überwachung seiner Reasoning-Schritte und Aktionen aus. Für ausgewählte Cybersecurity-Partner entfallen bestimmte Schutzbeschränkungen, damit sie sämtliche Verteidigungsfunktionen nutzen können.
Quelle: Google
Preis und Verfügbarkeit
Der Einführungspreis liegt bei 2 Dollar pro Million Input-Token und 10 Dollar pro Million Output-Token. Zwischengespeicherte Eingaben kosten 95 Prozent weniger. Damit unterbietet Google die Spitzenmodelle von Anthropic und OpenAI deutlich. Vergleichbar ist es beim Preis mit GPT-6.1 Sol und Claude Sonnet 5.5.
Zunächst erhalten ausgewählte Cybersecurity-Partner über das Fairwind-Programm Zugang. Google will Argon danach für Entwickler, Unternehmen und Privatnutzer öffnen. Bezahlte API-Kunden und Abonnenten von Google AI Ultra sollen zuerst an die Reihe kommen, einen Termin nennt das Unternehmen noch nicht.
Erste Einordnung durch Artificial Analysis
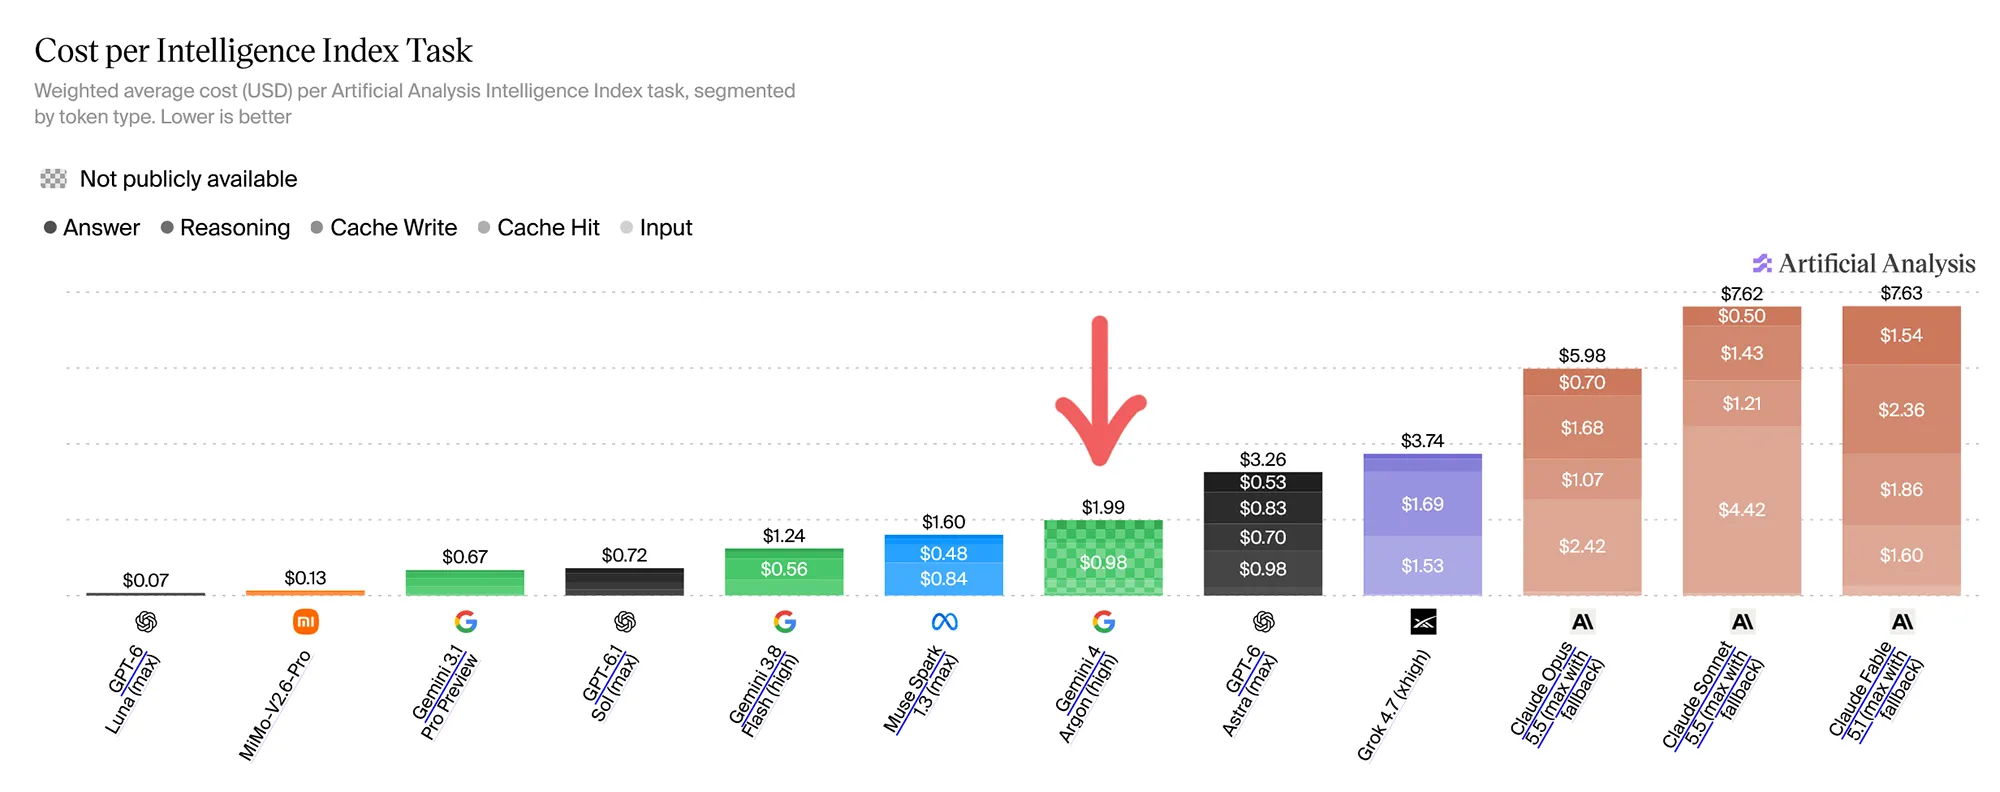
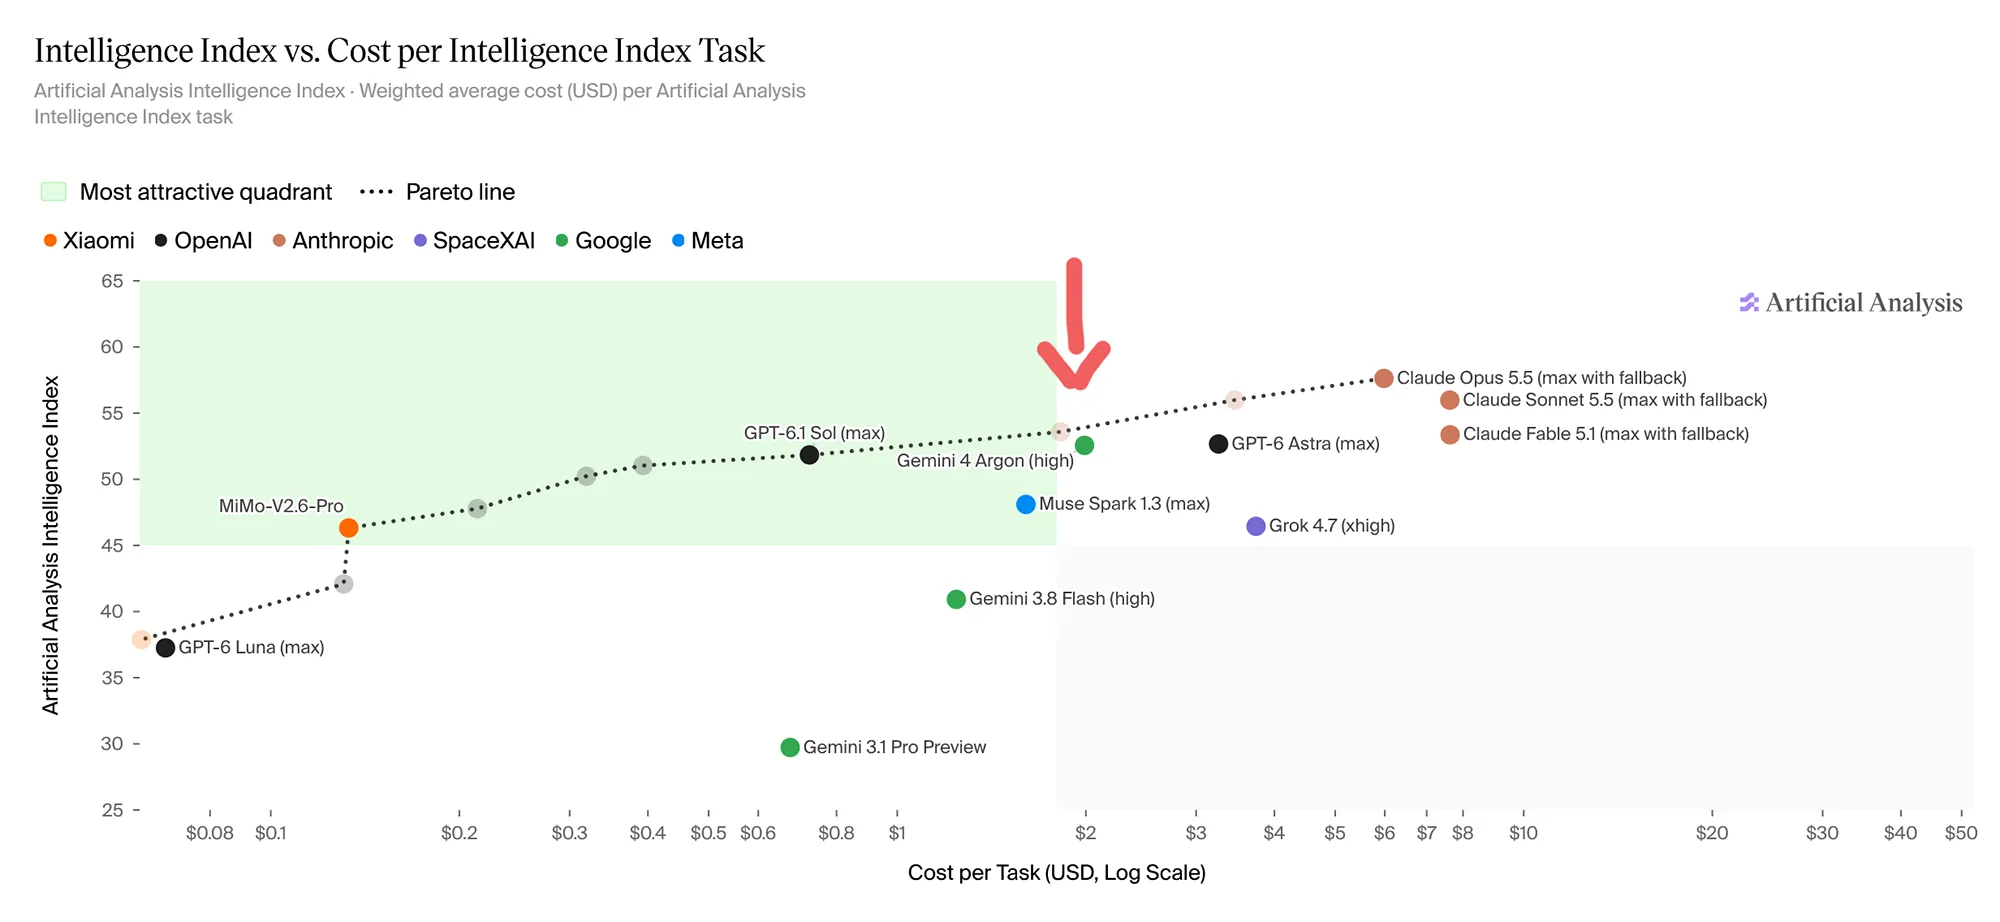
Ein erster Blick auf die Google-Benchmarks hat zu viel versprochen. Letztendlich scheint es ein Modell auf Fable- und Astra-Niveau zu sein, das aber deutlich günstiger ist. Ein Vergleich mit GPT 6.1 Sol und Claude Sonnet 5.5 ist daher eher angebracht.
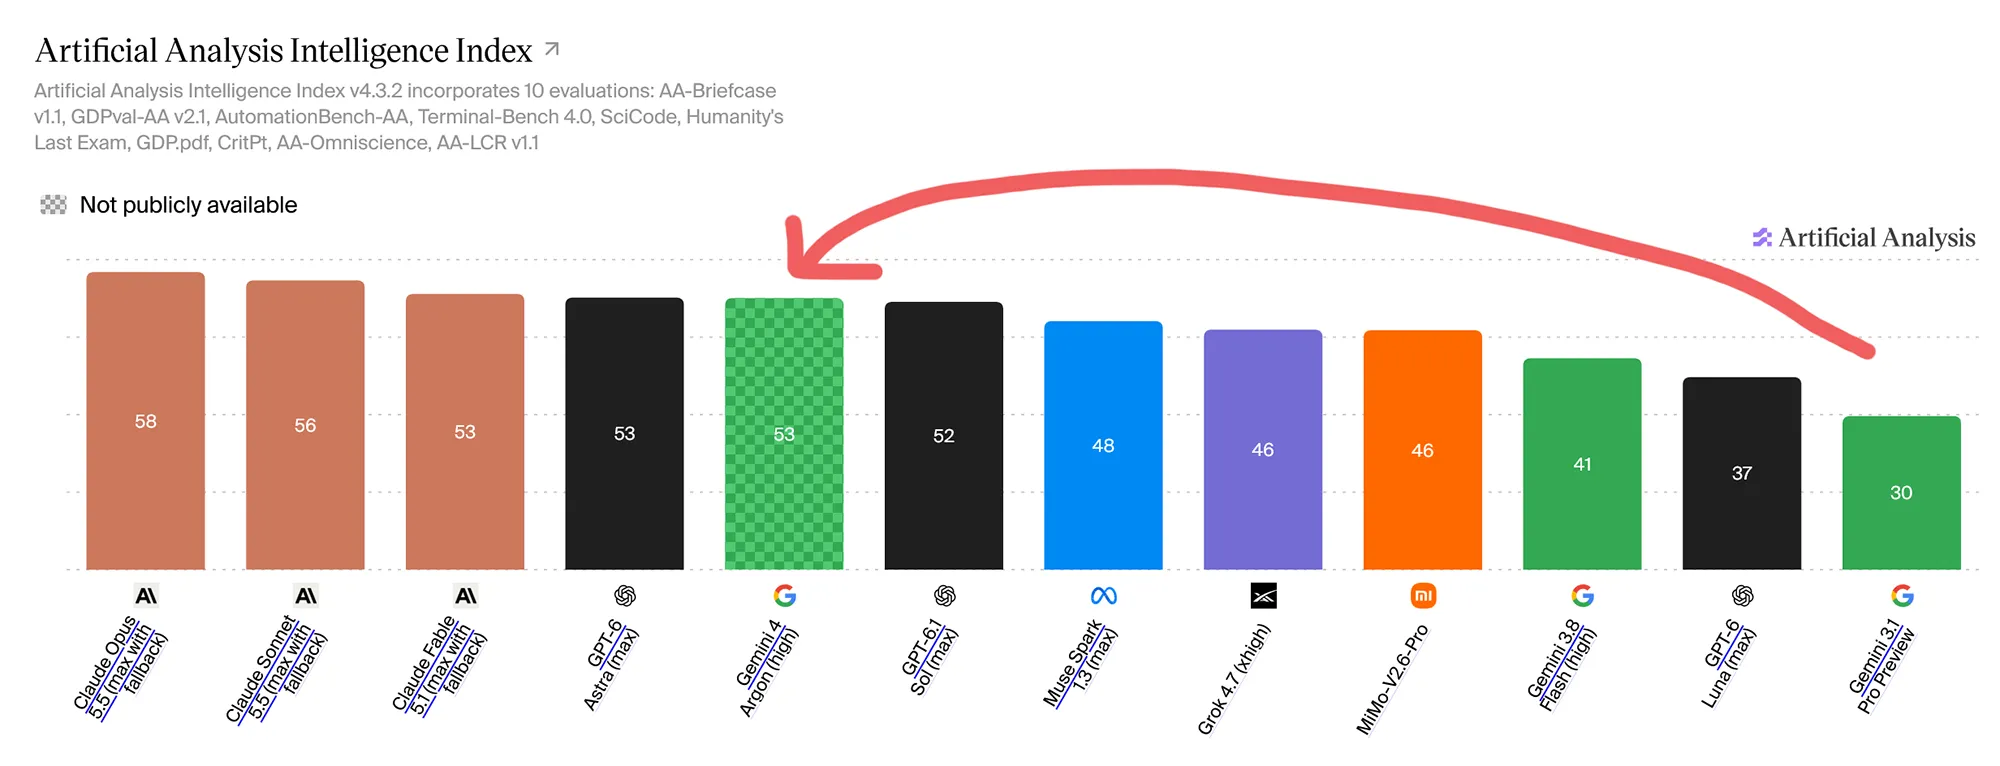
Quelle: Artificial Intelligence
Ich glaube, dass Astra und Fable ein Update dringend benötigen, ist mittlerweile relativ klar.
Claude Opus 5.5 High ist ähnlich teuer und ähnlich leistungsstark wie Gemini 4, GPT-6.1 ist einen Tick schwächer, aber auch günstiger.
Das erste Fazit ist daher, dass Google zurück ist und Gemini 3.1 Pro endlich einen würdigen Nachfolger bekommen hat.
Wie sich das Modell dann in der Praxis schlägt, werden die nächsten Tage zeigen.