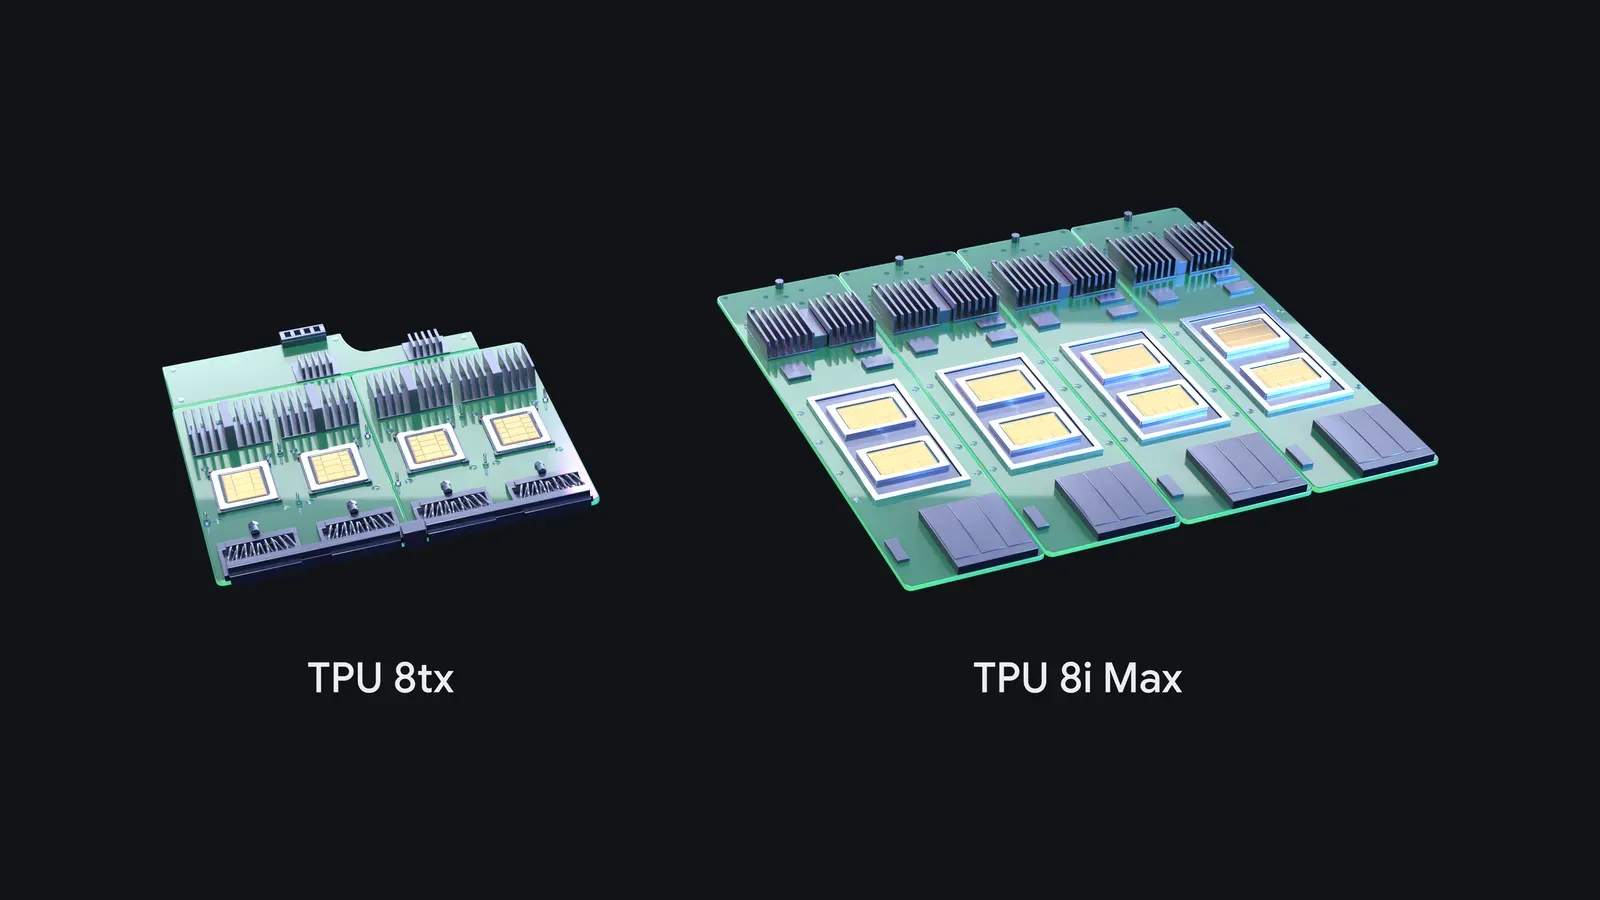
Google erweitert seine achte Generation von KI-Beschleunigern um TPU 8tx und TPU 8i Max. Der 8tx schützt vertrauliche Daten während der Verarbeitung, der 8i Max ist auf Aufgaben mit langen Kontexten ausgelegt, etwa wenn KI-Agenten eine ganze Codebasis durchsuchen oder stundenlange Videos auswerten.
Anzeige
TPU 8tx schützt Daten während der Berechnung
Für den TPU 8tx kombiniert Google den Chip des TPU 8t mit AMD-Epyc-Prozessoren der fünften Generation. Die Hardware schirmt sensible Daten und Modellgewichte auch während der Berechnung ab. Das ist etwa für Behörden und Unternehmen gedacht, die KI-Modelle mit vertraulichen Unterlagen nutzen oder mit eigenen Daten nachtrainieren wollen.
Google übernimmt außerdem das Boardfly-Netzwerk des TPU 8i. Es verkürzt die Wege zwischen den Chips. Laut Google sinkt die Verzögerung bei der Verarbeitung gegenüber dem TPU 8t um bis zu die Hälfte.
TPU 8i Max verbindet zwei Chips
Für den TPU 8i Max packt Google zwei TPU-8i-Chips in ein gemeinsames Gehäuse. Damit verdoppeln sich gegenüber dem TPU 8i die Rechenleistung, der schnelle Speicher direkt auf dem Chip und die Bandbreite zum Hauptspeicher des Beschleunigers.
Die zusätzliche Bandbreite hilft, wenn mehrere KI-Agenten parallel mit großen Datenmengen arbeiten. So können die Chips mehr Daten pro Sekunde aus dem Speicher abrufen. Das neue System braucht dabei im Serverrack genauso viel Platz wie der TPU 8i.
Zur achten Generation gehören damit vier TPU-Systeme. Den TPU 8t für das Training großer KI-Modelle und den TPU 8i für deren Betrieb mit kurzen Antwortzeiten hatte Google bereits im April vorgestellt.