Das beste Text-to-Speech-Modell kommt von Alibaba und verfügt über eine geniale Funktion.
Alibaba hat Qwen-Audio-3.1-TTS vorgestellt. Das Text-to-Speech-Modell liest Texte in verschiedenen Sprachen und chinesischen Dialekten vor. Das Besondere ist, dass wir zusätzlich einen kurzen Sprach-Clip übergeben können. Die erstellte Sprache klingt dann genau so. Für Stimmung, Tempo und Sprechstil genügen zudem Anweisungen in Alltagssprache.
Lachen und Seufzen an der richtigen Stelle
Wer einen Dialog vertont, kann zusätzlich einzelne Passagen im Text markieren. So lassen sich etwa Lachen, Seufzen oder ein Wechsel der Gefühlslage an einer bestimmten Stelle auslösen. Das macht die Steuerung für Hörbücher, Podcasts und vertonte Spielfiguren interessant.
Die Projektseite nennt 16 Sprachen und 20 chinesische Dialektregionen. Sie beschreibt auch die Erzeugung von bis zu drei Minuten Sprache in einem Durchgang. Bei der Übernahme einer Stimme aus einer Aufnahme soll das Modell selbst mit Rauschen und Hall zurechtkommen. Die 3.1-Flash-Version ist über Alibaba Cloud Model Studio für Anwendungen mit laufender Sprachausgabe verfügbar.
Wir übergeben z.B. den folgenden Clip zusammen mit dem Prompt: »Die häufigste Unfallursache im Winter sind rutschige Straßen, Gehwege (Bürgersteige) und vor allem Stufen.«
Die Ausgabe mit Qwen klingt dann so:
Anzeige
Top bei Chinesisch, sehr gut auf Deutsch
In den veröffentlichten CV3-Eval-Grafiken liegt Qwen-Audio-3.1-TTS bei der Ähnlichkeit zur vorgegebenen Stimme in vielen der gezeigten Sprachen vor MiniMax Speech 2.8 HD und ElevenLabs v3. Bei der Texttreue ist das Bild weniger eindeutig. Dort schneiden andere Modelle in einzelnen Sprachen knapp besser ab.
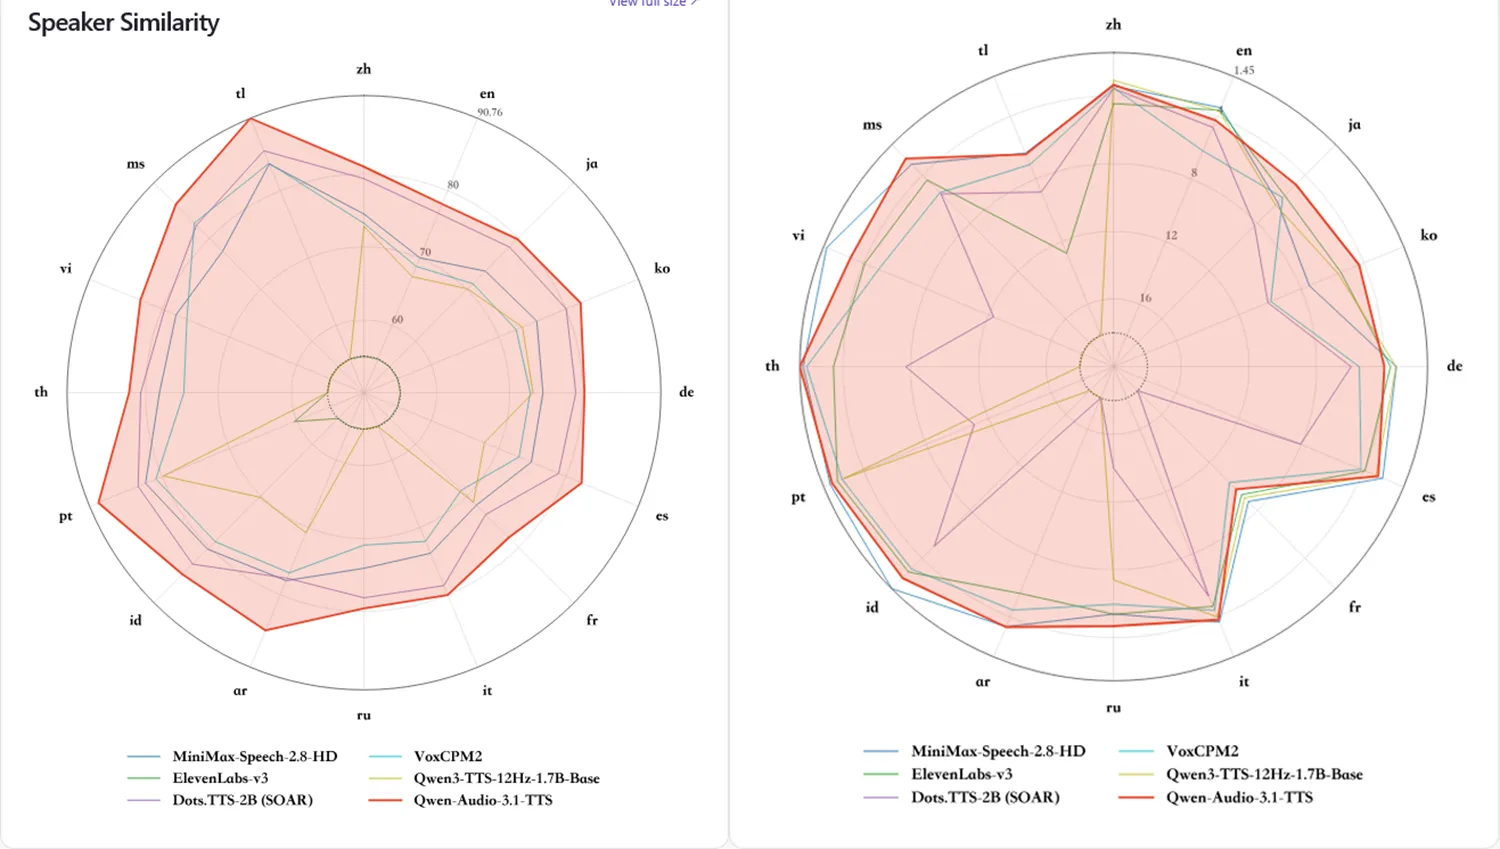
Quelle: Alibaba
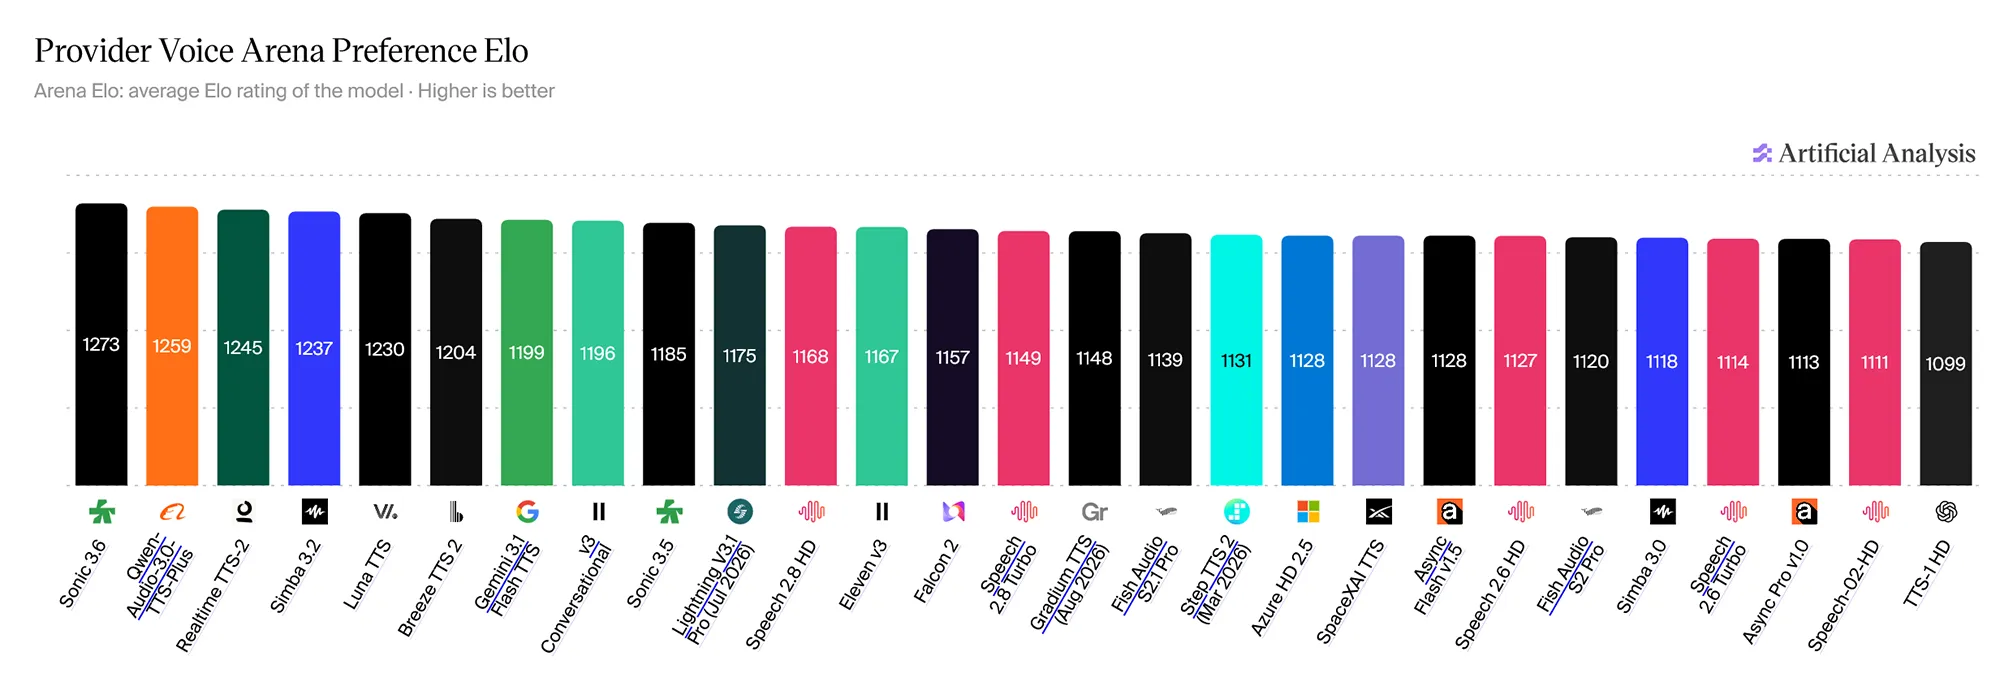
Wenn man sich die Werte auf Artificial Intelligence für das Vorgängermodell von Qwen an, welches dort schon auf Platz 2 liegt, dann dürfte Qwen Audio 3.1 aktuell wohl das beste Text-to-Speech-Modell sein.
Quelle: Alibaba
Alibaba hat zugleich die Preise seiner Audiomodelle gesenkt. Damit richtet sich 3.1-TTS-Flash besonders an Entwickler, die Stimmen in Assistenten oder andere Anwendungen mit schneller Ausgabe einbauen wollen.