OpenAI will gemeinsames robots.txt-Signal für KI-Training respektieren
OpenAI will künftig ein gemeinsames Signal in der Datei »robots.txt« respektieren. Betreiber einer Website sollen damit mehreren KI-Anbietern gleichzeitig mitteilen können, ob ihre Inhalte für das Training generativer KI-Modelle genutzt werden dürfen.
Die Unterstützung ist noch nicht aktiv. OpenAI plant die Umsetzung in den kommenden Monaten und will später technische Details veröffentlichen.
Ein Eintrag soll mehrere KI-Anbieter erreichen
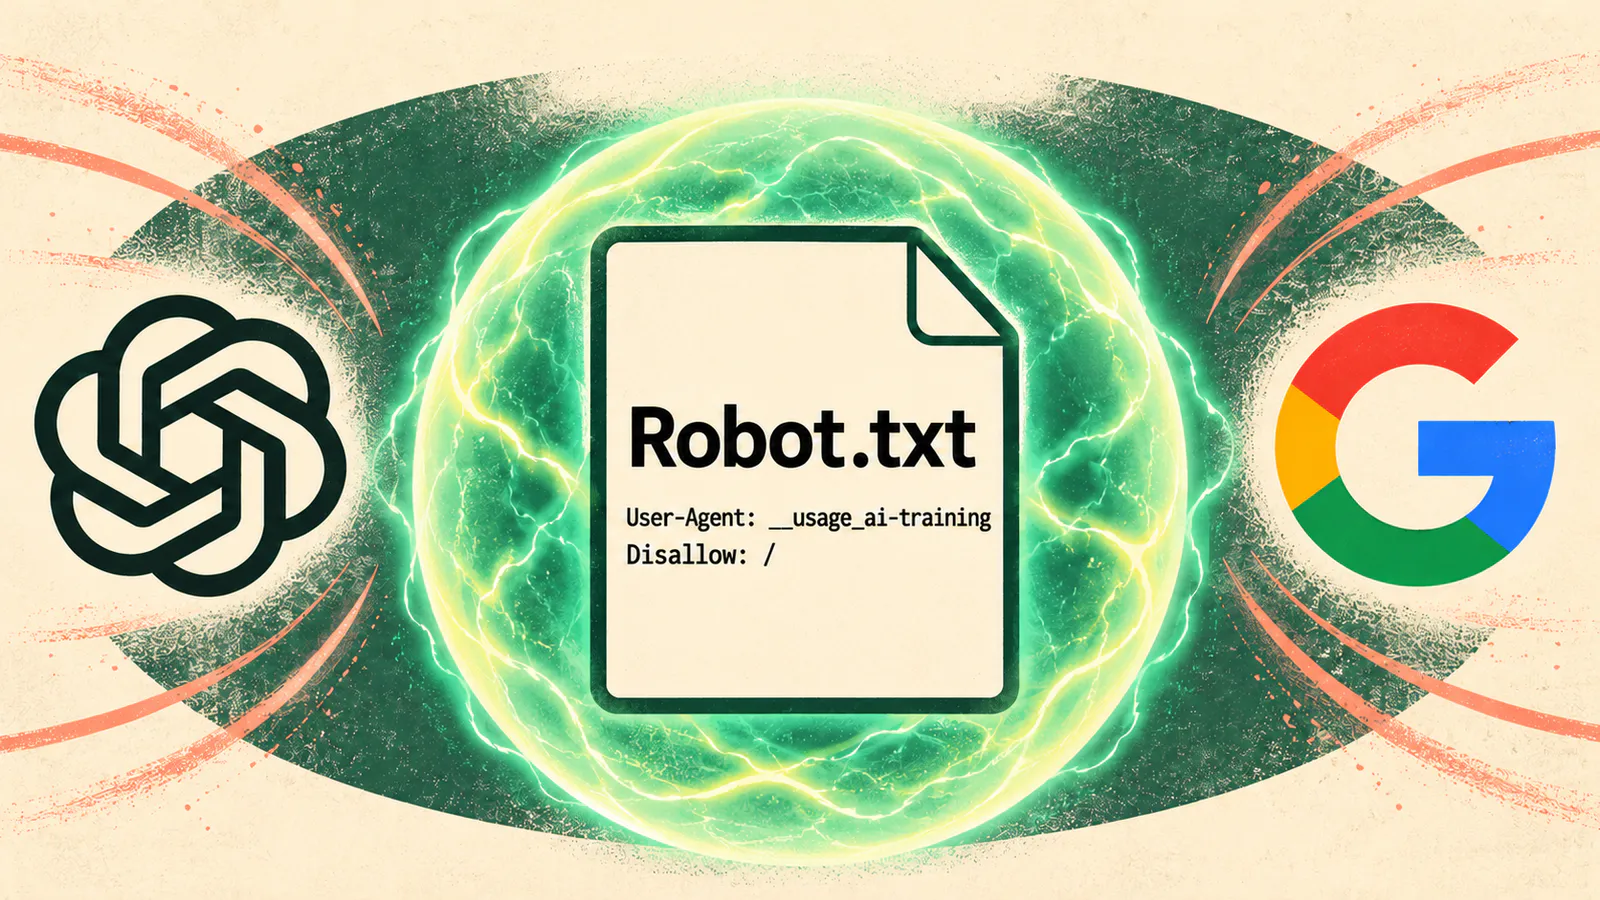
Bisher müssen Betreiber einzelne Crawler wie GPTBot ansprechen und für jeden Anbieter eigene Regeln pflegen. Der neue Vorschlag verwendet stattdessen einen gemeinsamen Eintrag für den Zweck »KI-Training« und kombiniert ihn mit den bekannten Regeln »Allow« und »Disallow«.
Ein vollständiger Ausschluss sieht im Entwurf so aus:
»User-Agent: __usage_ai-training
Disallow: /«
Eine Freigabe für einzelne Bereiche ist ebenfalls möglich. So kann ein Betreiber etwa die gesamte Website vom Training ausschließen, aber Inhalte in einem Presseordner erlauben.
Anzeige
Bestehende Regeln gelten weiter
Das Signal legt fest, wie bereits abgerufene Inhalte verwendet werden sollen. Es steuert nicht, ob ein Crawler eine Seite besuchen darf. Die bisherigen Regeln für GPTBot und andere OpenAI-Crawler gelten deshalb weiter und sollen nicht ersetzt werden.
Der Vorschlag stammt aus einem neuen Internet-Draft von Kevin Kelley, der bei Anthropic arbeitet. Er greift die Begriffe der IETF-Arbeitsgruppe AI Preferences auf, ist derzeit aber noch kein verabschiedeter Standard.
Für Betreiber sinkt der Pflegeaufwand, sobald mehrere KI-Anbieter denselben Eintrag respektieren. Wer GPTBot schon heute getrennt steuert, sollte seine vorhandenen Regeln bis zur Umsetzung beibehalten.