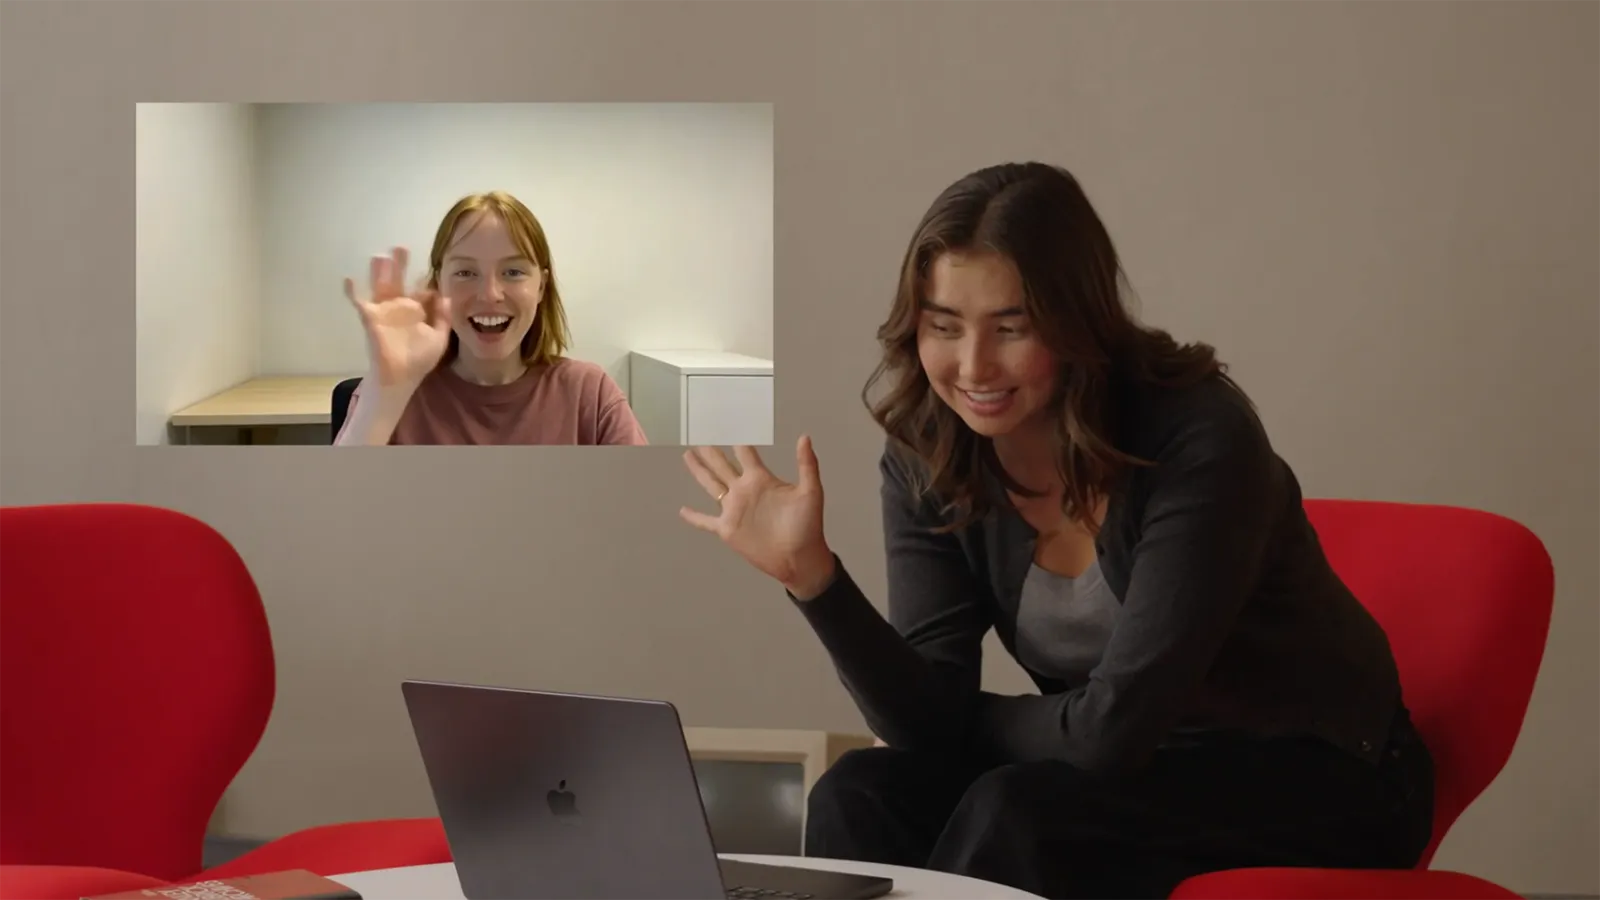
Mit Griffin stellt Tavus ein neues KI-Modell für interaktive Videogespräche vor, das bei der Natürlichkeit einen deutlichen Sprung macht. Es erzeugt menschlich wirkende Gesprächspartner, die gleichzeitig sprechen, zuhören und auf das reagieren, was sie sehen. Fast jeder zweite Teilnehmer eines Videoanrufs hielt die Vorschauversion Griffin-Lite für einen echten Menschen.
Ein KI-Gegenüber, das sieht, zuhört und reagiert
Griffin erzeugt Gesicht, Stimme und Bewegungen seines KI-Gegenübers in Echtzeit. Während der Nutzer spricht, kann das Modell nicken, kurze Bestätigungen einwerfen oder seinen Gesichtsausdruck verändern. Es berücksichtigt Mimik, Gesten und Gesprächspausen, lässt sich unterbrechen und passt seine Reaktionen dem Gesprächsverlauf an.
Für das Aussehen genügt ein Referenzfoto, für eine geklonte Stimme eine rund zehnsekündige Aufnahme. Der Videogenerator erzeugt die gesamte Szene mit 720p-Auflösung und 25 Bildern pro Sekunde. Dazu gehören auch Hände, Körperbewegungen, Schatten und der Hintergrund.
Als mögliche Anwendungen nennt Tavus Nachhilfe, das Üben schwieriger Gespräche oder einen Kundendienst, dem der Nutzer ein defektes Bauteil vor die Kamera hält. Ein virtueller Nachhilfelehrer könnte beispielsweise am Gesichtsausdruck erkennen, dass sein Schüler eine Erklärung nicht verstanden hat, und einen anderen Ansatz wählen.
Solche KI-Gesprächspartner nennt Tavus PALs. Mit dem PAL Maker lassen sie sich ohne Programmierkenntnisse beschreiben, mit Gesicht und Stimme ausstatten und in eine Webseite oder App einbinden. Entwickler können die Tavus-API verwenden. Diese Angebote arbeiten bislang mit den bisherigen Tavus-Modellen.
Anzeige
Gleichzeitiges Zuhören und Antworten
Griffin verbindet eine fortlaufende Gesprächssteuerung mit Generatoren für Sprache und Video. Die Steuerung verarbeitet Bild und Ton und entscheidet mehrmals pro Sekunde, ob und wie das Modell reagiert. Auch während eigener Antworten hört und sieht Griffin weiter zu.
Stimme, Blick und Gesten folgen dabei derselben Steuerung. Dadurch kann das Modell noch mitten im Satz den Tonfall ändern oder auf eine Unterbrechung reagieren. Das Video entsteht fortlaufend in kurzen Abschnitten.
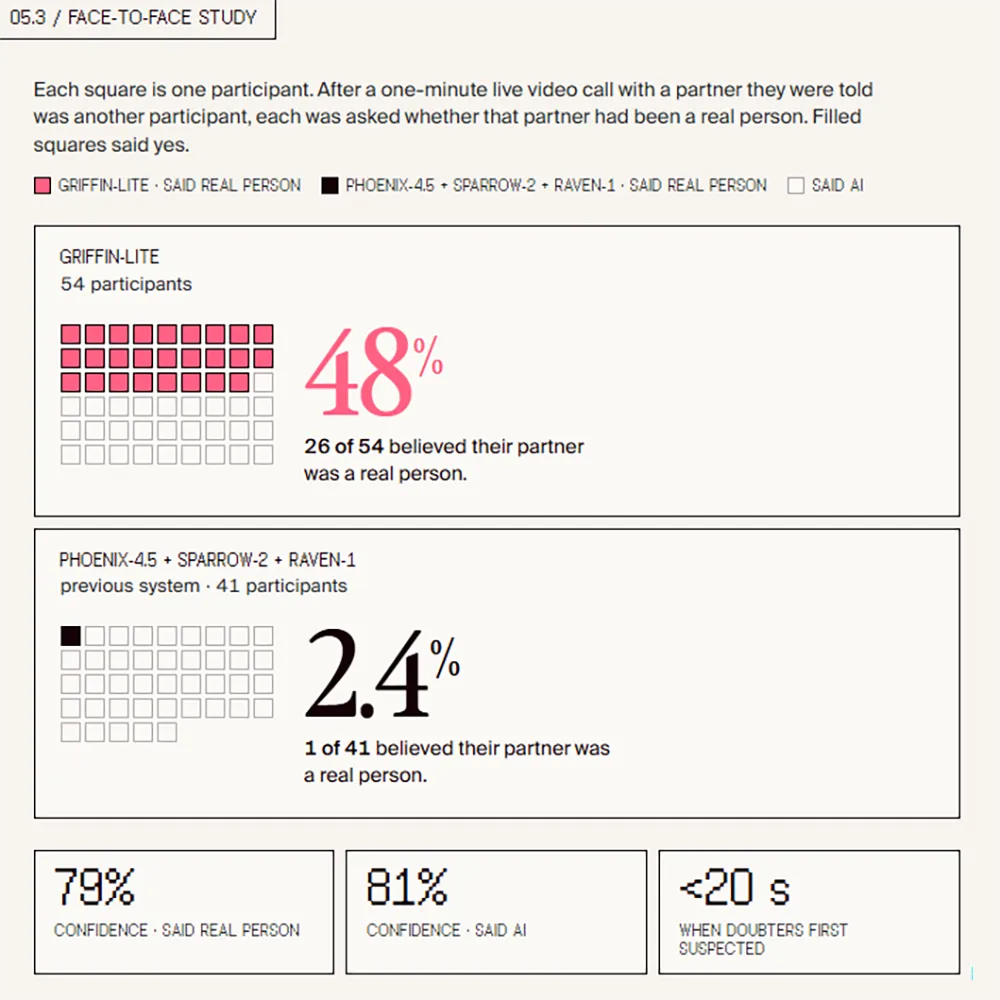
Wie überzeugend das wirkt, zeigt eine Studie mit einminütigen Videoanrufen. Von 54 Teilnehmern, denen ein menschlicher Gesprächspartner angekündigt worden war, hielten 26 ihr KI-Gegenüber anschließend für einen Menschen. Das entspricht 48 Prozent, gegenüber einem von 41 Teilnehmern beim bisherigen Tavus-System.
Quelle: Tavus
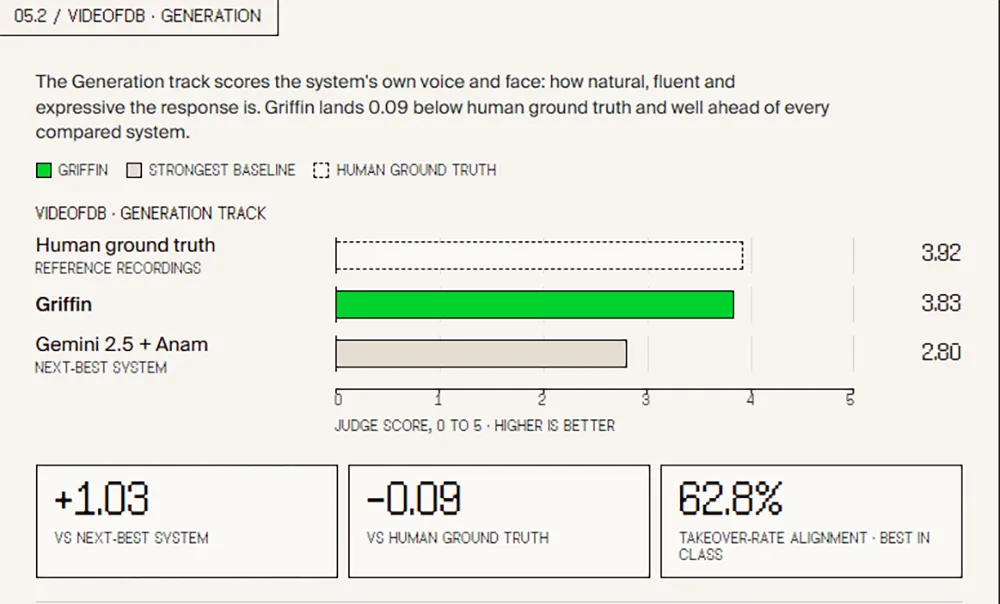
Im von Nvidia ausgewerteten Benchmark VideoFDB erreicht Griffin für erzeugte Sprache und Video 3,83 von fünf Punkten. Menschliche Referenzaufnahmen liegen bei 3,92 Punkten, das nächstbeste Vergleichssystem aus Gemini 2.5 und Anams Avatar-Technik bei 2,80. Ein Sprachmodell bewertet dabei unter anderem Sprachfluss, passende Emotionen und nonverbale Reaktionen.
Quelle: Tavus
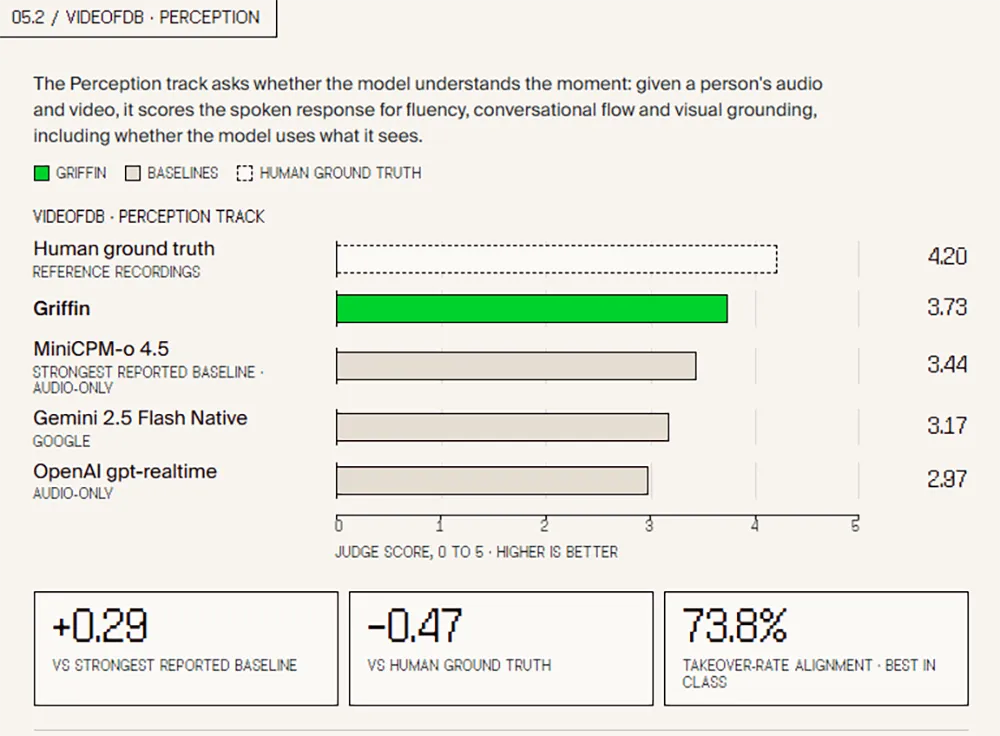
Beim Verstehen der Gesprächssituation kommt Griffin auf 3,73 Punkte, Menschen auf 4,20. MiniCPM-o 4.5 folgt mit 3,44, Gemini 2.5 Flash Native mit 3,17 und OpenAIs gpt-realtime mit 2,97 Punkten. MiniCPM und das OpenAI-Modell liefen hier ausschließlich mit Audioeingaben, Griffin zusätzlich mit Video.
Quelle: Tavus
Verfügbarkeit und Preise
Griffin-Lite ist zunächst ausgewählten Testern als Forschungsvorschau zugänglich. Interessenten können Zugang bei Tavus anfragen. Einen öffentlichen Starttermin und eigene Griffin-Preise nennt das Unternehmen noch nicht.
Die bestehende Tavus-Plattform bietet 20 kostenlose Gesprächsminuten. Starter kostet monatlich 22 Dollar für 60 Minuten, Builder 59 Dollar für 175 Minuten, Growth 397 Dollar für 1.300 Minuten und Business 975 Dollar für 4.000 Minuten. Ab Builder wird zusätzliche Nutzung separat berechnet. Griffin ist in diesen Tarifen bislang nicht enthalten.