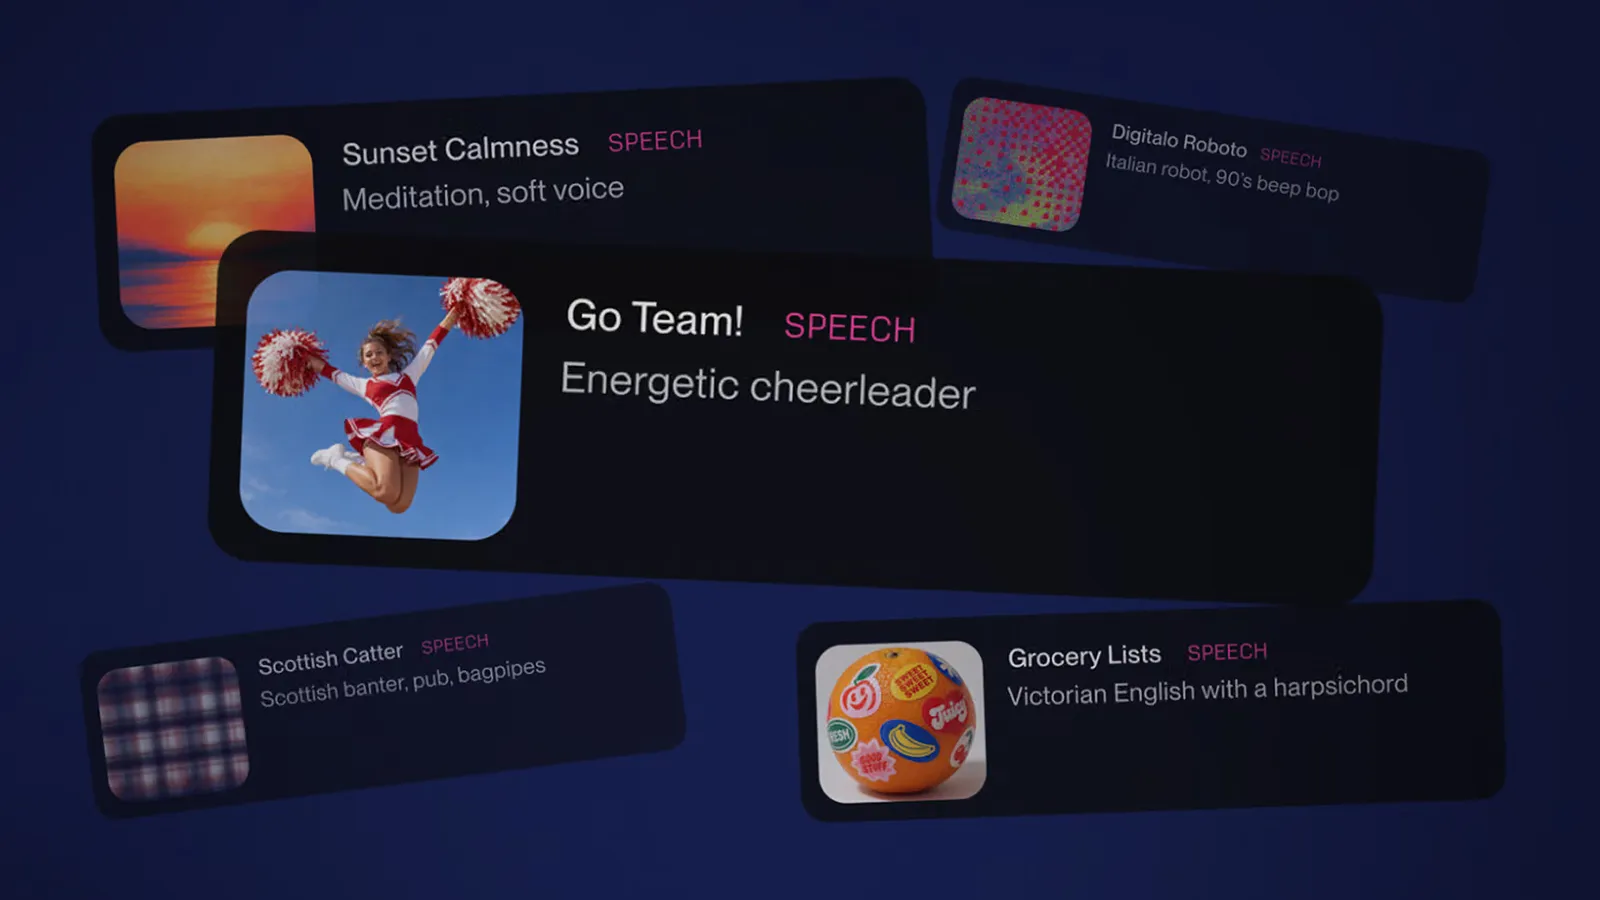
Suno erweitert seinen KI-Musikdienst um gesprochene Inhalte. Die neue Funktion Speech erzeugt Stimme und passende Hintergrundmusik gemeinsam als eine Audiospur. Aus einer Idee oder einem fertigen Text entstehen so etwa Erzählungen, Gedichte, Meditationen und Vertonungen für Videos.
Speech führt Stimme und Musik zusammen
Speech ist direkt in den »Erstellen-Bereich« von Suno integriert und lässt sich im Browser sowie auf dem Smartphone nutzen. Im einfachen Modus genügt eine Beschreibung des gewünschten Ergebnisses. Das Modell schreibt daraufhin den gesprochenen Text, vertont ihn und komponiert auf Wunsch die Musik dazu.
Wer den Wortlaut selbst bestimmen möchte, fügt stattdessen ein fertiges Skript ein. Ein zusätzliches Stilfeld steuert Stimme, Stimmung und Sprechweise. Damit kann derselbe Text beispielsweise ruhig und sachlich oder zunehmend hektisch vorgetragen werden.
Der entscheidende Unterschied zu einem herkömmlichen Voiceover mit nachträglich unterlegter Musik liegt in der gemeinsamen Erzeugung. Stimme und Komposition sollen aufeinander reagieren, damit sich der Soundtrack an Tempo und Stimmung orientiert. Für reine Sprachaufnahmen lässt sich die Hintergrundmusik abschalten.
Anzeige
Bis zu acht Minuten lange Sprachaufnahmen
Eine Generierung kann bis zu rund acht Minuten dauern. Damit deckt Speech neben kurzen Ansagen auch längere Monologe, Geschichten und Erklärstücke ab. Als weitere Einstellungen bietet Suno eine Auswahl des Geschlechts der Stimme und einen Regler für die gewünschte Vielfalt der Ausgabe.
Suno hat Speech im vergangenen Monat mit einer kleinen Nutzergruppe getestet und öffnet die Beta nun für alle. Fertig ist die Funktion noch nicht. Akzente können während einer Aufnahme die geografische Richtung wechseln, während dramatische Pausen mitunter länger als beabsichtigt ausfallen. Genau solche Fehler will das Unternehmen mithilfe der Rückmeldungen aus der breiteren Nutzung verbessern.