Microsoft will seine selbst entwickelten Azure-Maia-Beschleuniger ab 2027 in großem Maßstab einsetzen. Maia soll damit zur wichtigsten Infrastruktur für Copilot, Foundry und weitere Produkte und Dienste des Konzerns werden.
Die aktuelle Generation Maia 200 verarbeitet bereits produktive Workloads von Microsoft Copilot und des MAI-Teams. GitHub Copilot und Microsoft Foundry sollen bis Ende 2026 folgen.
Maia 300 zielt auf KI-Agenten und lange Kontexte
Maia 300 ist die dritte Generation der Chipfamilie und geht 2027 in den Produktiveinsatz. Microsoft richtet den Beschleuniger auf Long-Context-Reasoning, schnelle Dialoge und dauerhaft laufende, mehrstufige Aufgaben von KI-Agenten aus.
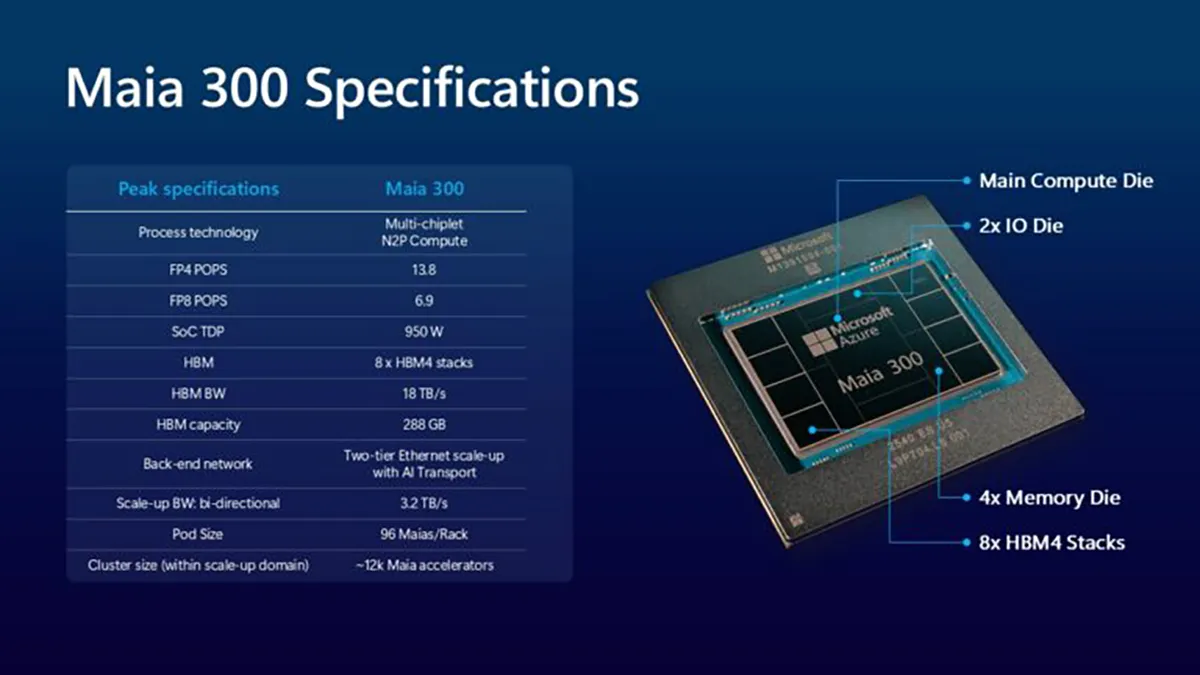
Der Konzern beziffert die Leistung auf 40 Prozent mehr Token pro Megawatt als bei führenden GPU-Systemen. Ein vollständiges Rack mit 96 Maia-300-Beschleunigern erreicht zudem bis zu siebenmal so viel Token-Durchsatz wie Maia 200.
Jeder Beschleuniger besitzt 288 GB HBM4 mit einer Speicherbandbreite von 18 TB/s und einer Leistungsaufnahme von 950 Watt. Die Multi-Chiplet-Architektur trennt Recheneinheiten, Speichercontroller und Ein- sowie Ausgabe. Die Compute-Chiplets entstehen bei TSMC im N2P-Verfahren.
Quelle: Microsoft
Ein Rack nimmt 96 Beschleuniger auf und kommt damit auf insgesamt 27,6 TB HBM sowie eine gebündelte Speicherbandbreite von 1,7 PB/s. Dafür benötigt es 167 Kilowatt. Ein Ethernet-basiertes Netzwerk verbindet die Chips innerhalb eines Racks und über mehrere Racks hinweg.
Maia 200 läuft bereits in den USA, Europa und Australien. Bei integrierten KI-Funktionen in Teams, Copilot und Cowork verarbeitet der Vorgänger bis zu 1,7-mal mehr Token pro Watt als aktuelle GPU-Infrastruktur laut Microsoft.
Anzeige