Microsoft erweitert sein Angebot für Sprachverarbeitung um drei neue Modelle. MAI-Transcribe-2-Streaming führt direkt die Streaming-Rangliste von Artificial Analysis an. Mit MAI-Voice-2.1 und einer schnelleren Flash-Variante liefert der Konzern zugleich passende Stimmen für mehrsprachige Voice Agents.
Transkription beginnt schon während des Sprechens
MAI-Transcribe-2-Streaming erstellt Echtzeit-Transkripte in 60 Sprachen und erkennt dabei auch Sprachwechsel. Erste vorläufige Wörter erscheinen etwas mehr als 100 Millisekunden nach Eingang des Audios. Das Modell korrigiert diese Teiltranskripte mit wachsendem Kontext und legt anschließend eine stabile Fassung fest.
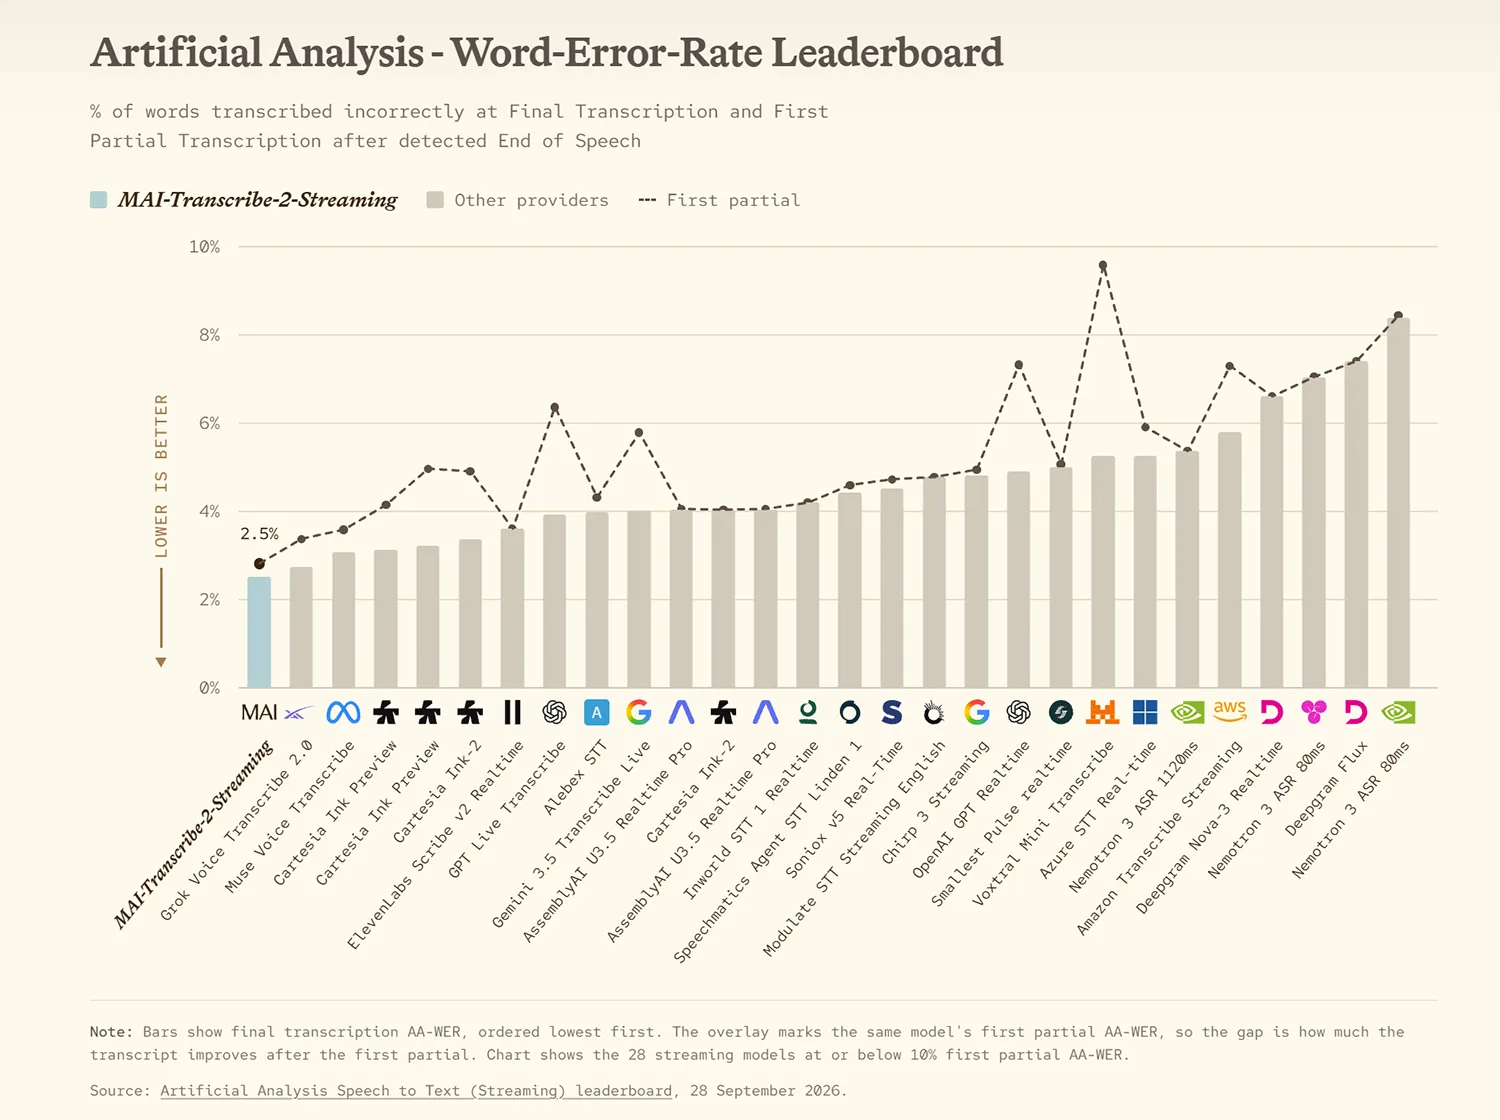
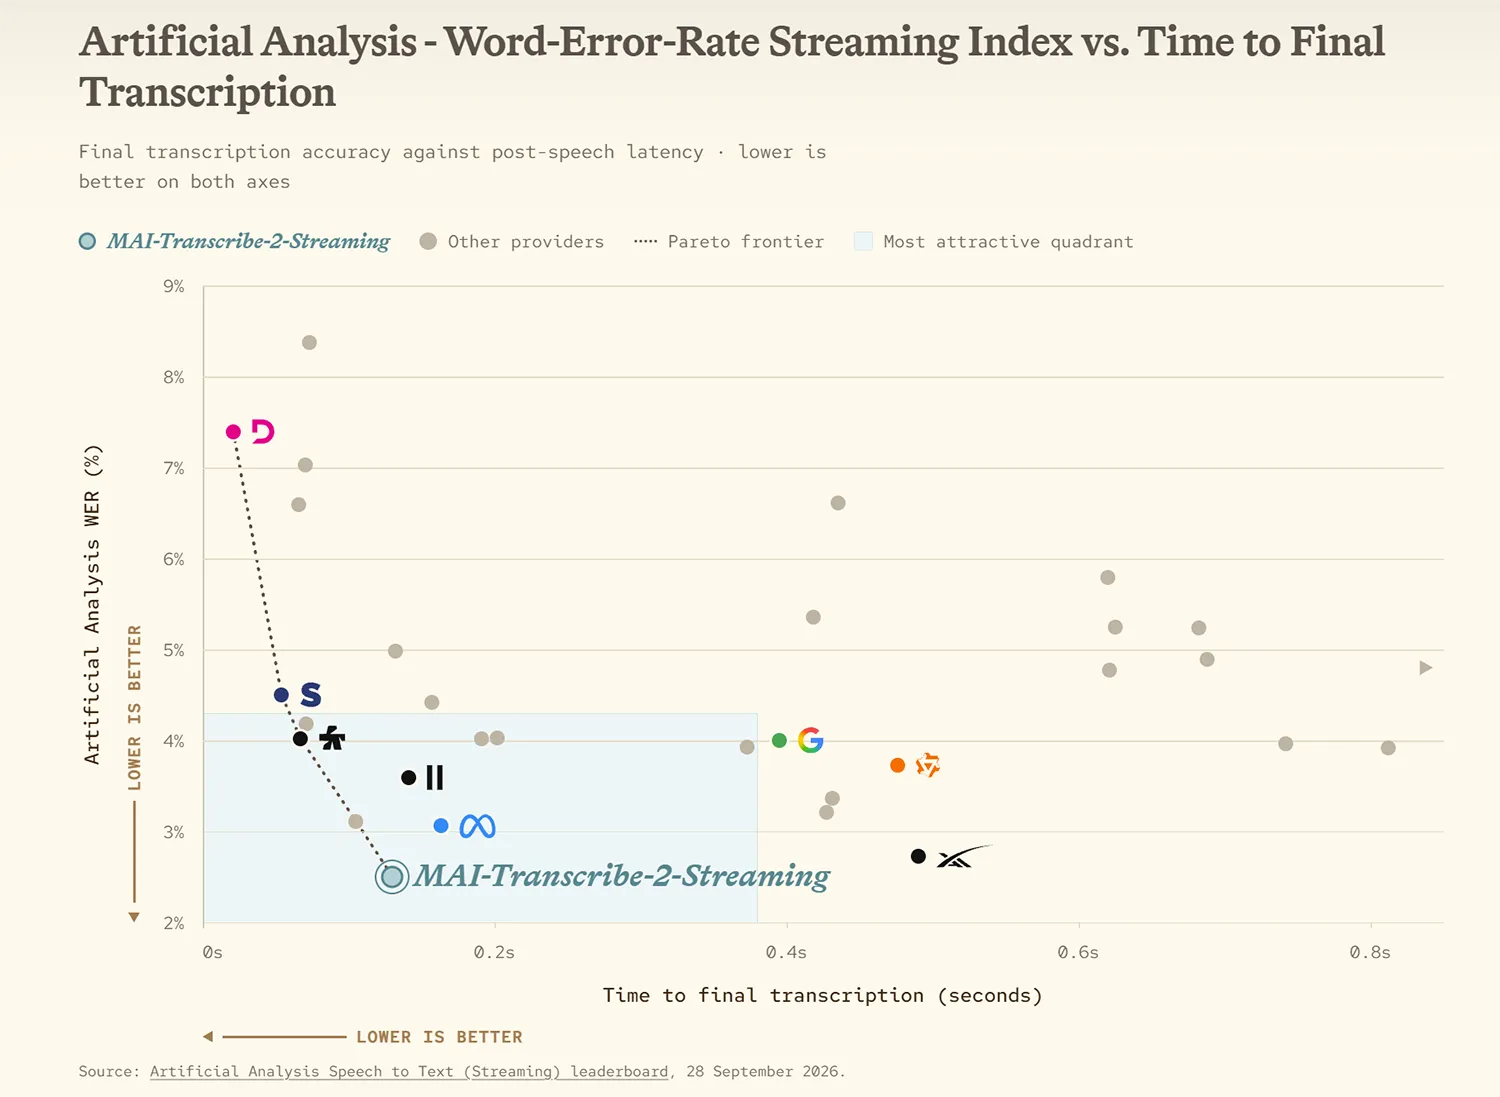
Im Streaming-Benchmark von Artificial Analysis erreicht es mit einer Wortfehlerrate von 2,5 Prozent den besten Wert der untersuchten Modelle. Auch bei den ersten Teiltranskripten liegt Microsoft vorn. Die Auswertung berücksichtigt rund acht Stunden Audiomaterial aus Gesprächen, Parlamentsaufnahmen und Unternehmenskonferenzen.
Quelle: Microsoft
Dadurch können Voice Agents bereits reagieren oder Funktionen aufrufen, bevor ein Nutzer seinen Satz beendet hat. Bei Diktaten und Untertiteln sollen Wörter doppelt so schnell erscheinen wie beim nächsten Konkurrenten. Bis zum Jahresende kostet die Verarbeitung einer Audiostunde 0,54 Dollar.
Quelle: Microsoft
Eine Stimme spricht 23 Sprachen
MAI-Voice-2.1 erzeugt Sprache in 23 Sprachen und 26 regionalen Varianten. Dieselbe geklonte Stimme kann zwischen Deutsch, Englisch oder Mandarin wechseln und dabei den jeweiligen Akzent übernehmen. Microsoft verlangt 22 Dollar je eine Million Zeichen.
Anzeige
MAI-Voice-2.1-Flash unterstützt dieselben Sprachen, richtet sich aber an große Mengen und Anwendungen mit geringer Wartezeit. Das Modell erzeugt 45 Sekunden Audio bei einer Ende-zu-Ende-Latenz von 150 Millisekunden. Die Berechnung läuft 55 Prozent schneller, der Preis liegt bei 15 Dollar je eine Million Zeichen.
Beide Sprachmodelle können aus wenigen Sekunden Referenzmaterial eine Stimme klonen. Eingebaute Einwilligungsprüfungen sollen Missbrauch verhindern. Die Modelle stehen unter anderem über Microsoft Foundry und den MAI Playground bereit, die beiden Voice-Varianten außerdem über OpenRouter.