
MiniMax bringt mit M3.1 Flash ein günstiges Open-Weight-Modell für KI-Agenten, Coding und anspruchsvolle Büroaufgaben. Es rechnet rund dreimal schneller als M3 und kostet über die API nur halb so viel.
Starke Werte bei Agenten, Coding und Bildverständnis
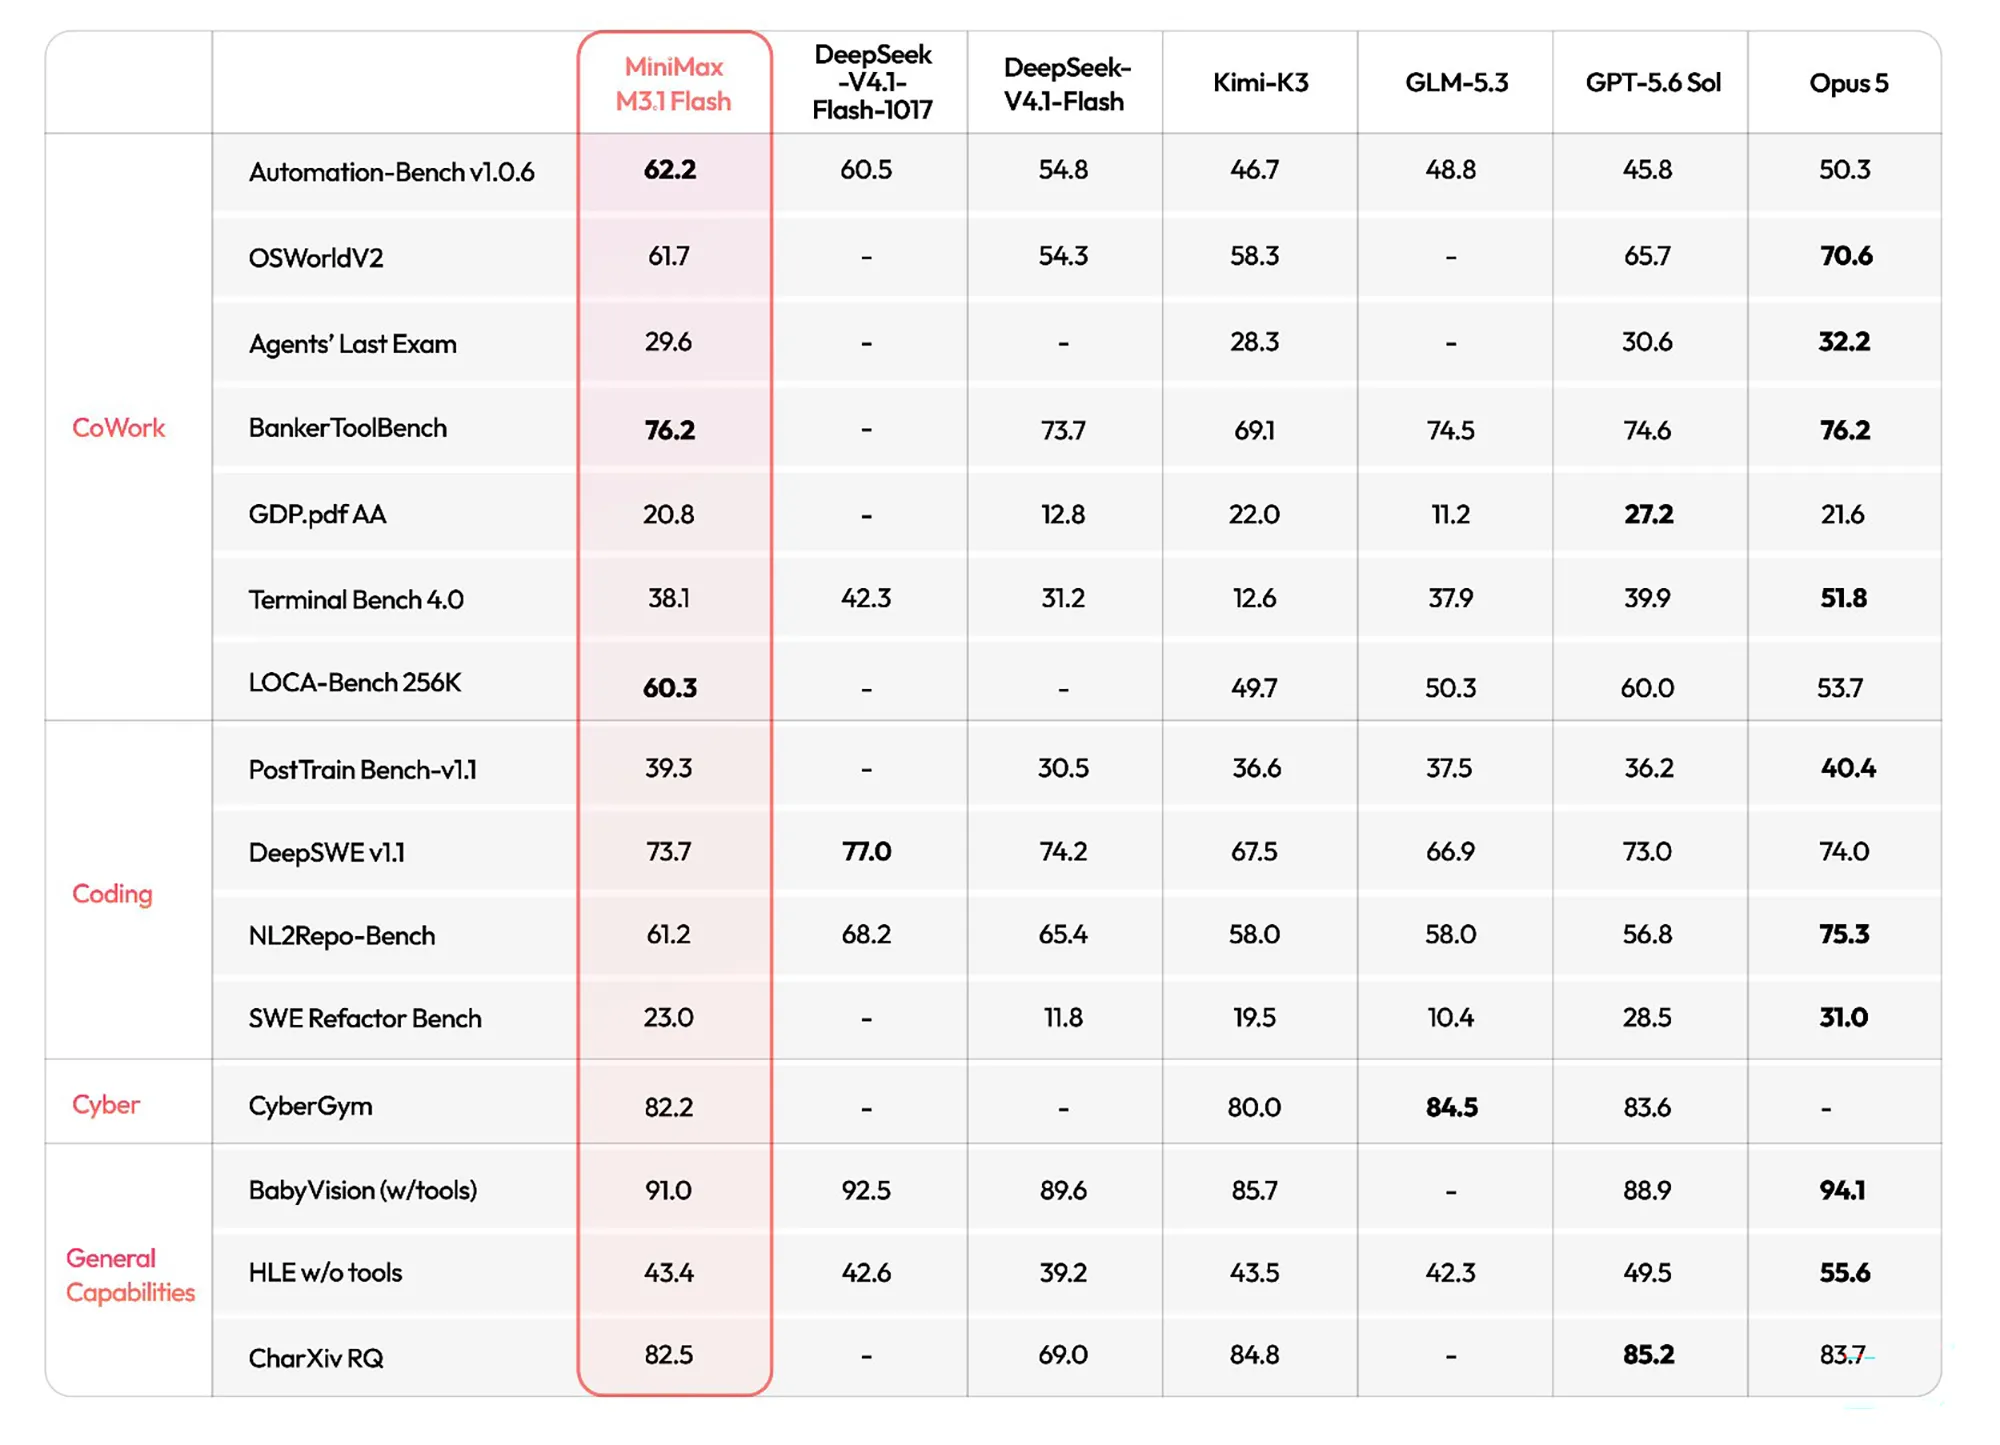
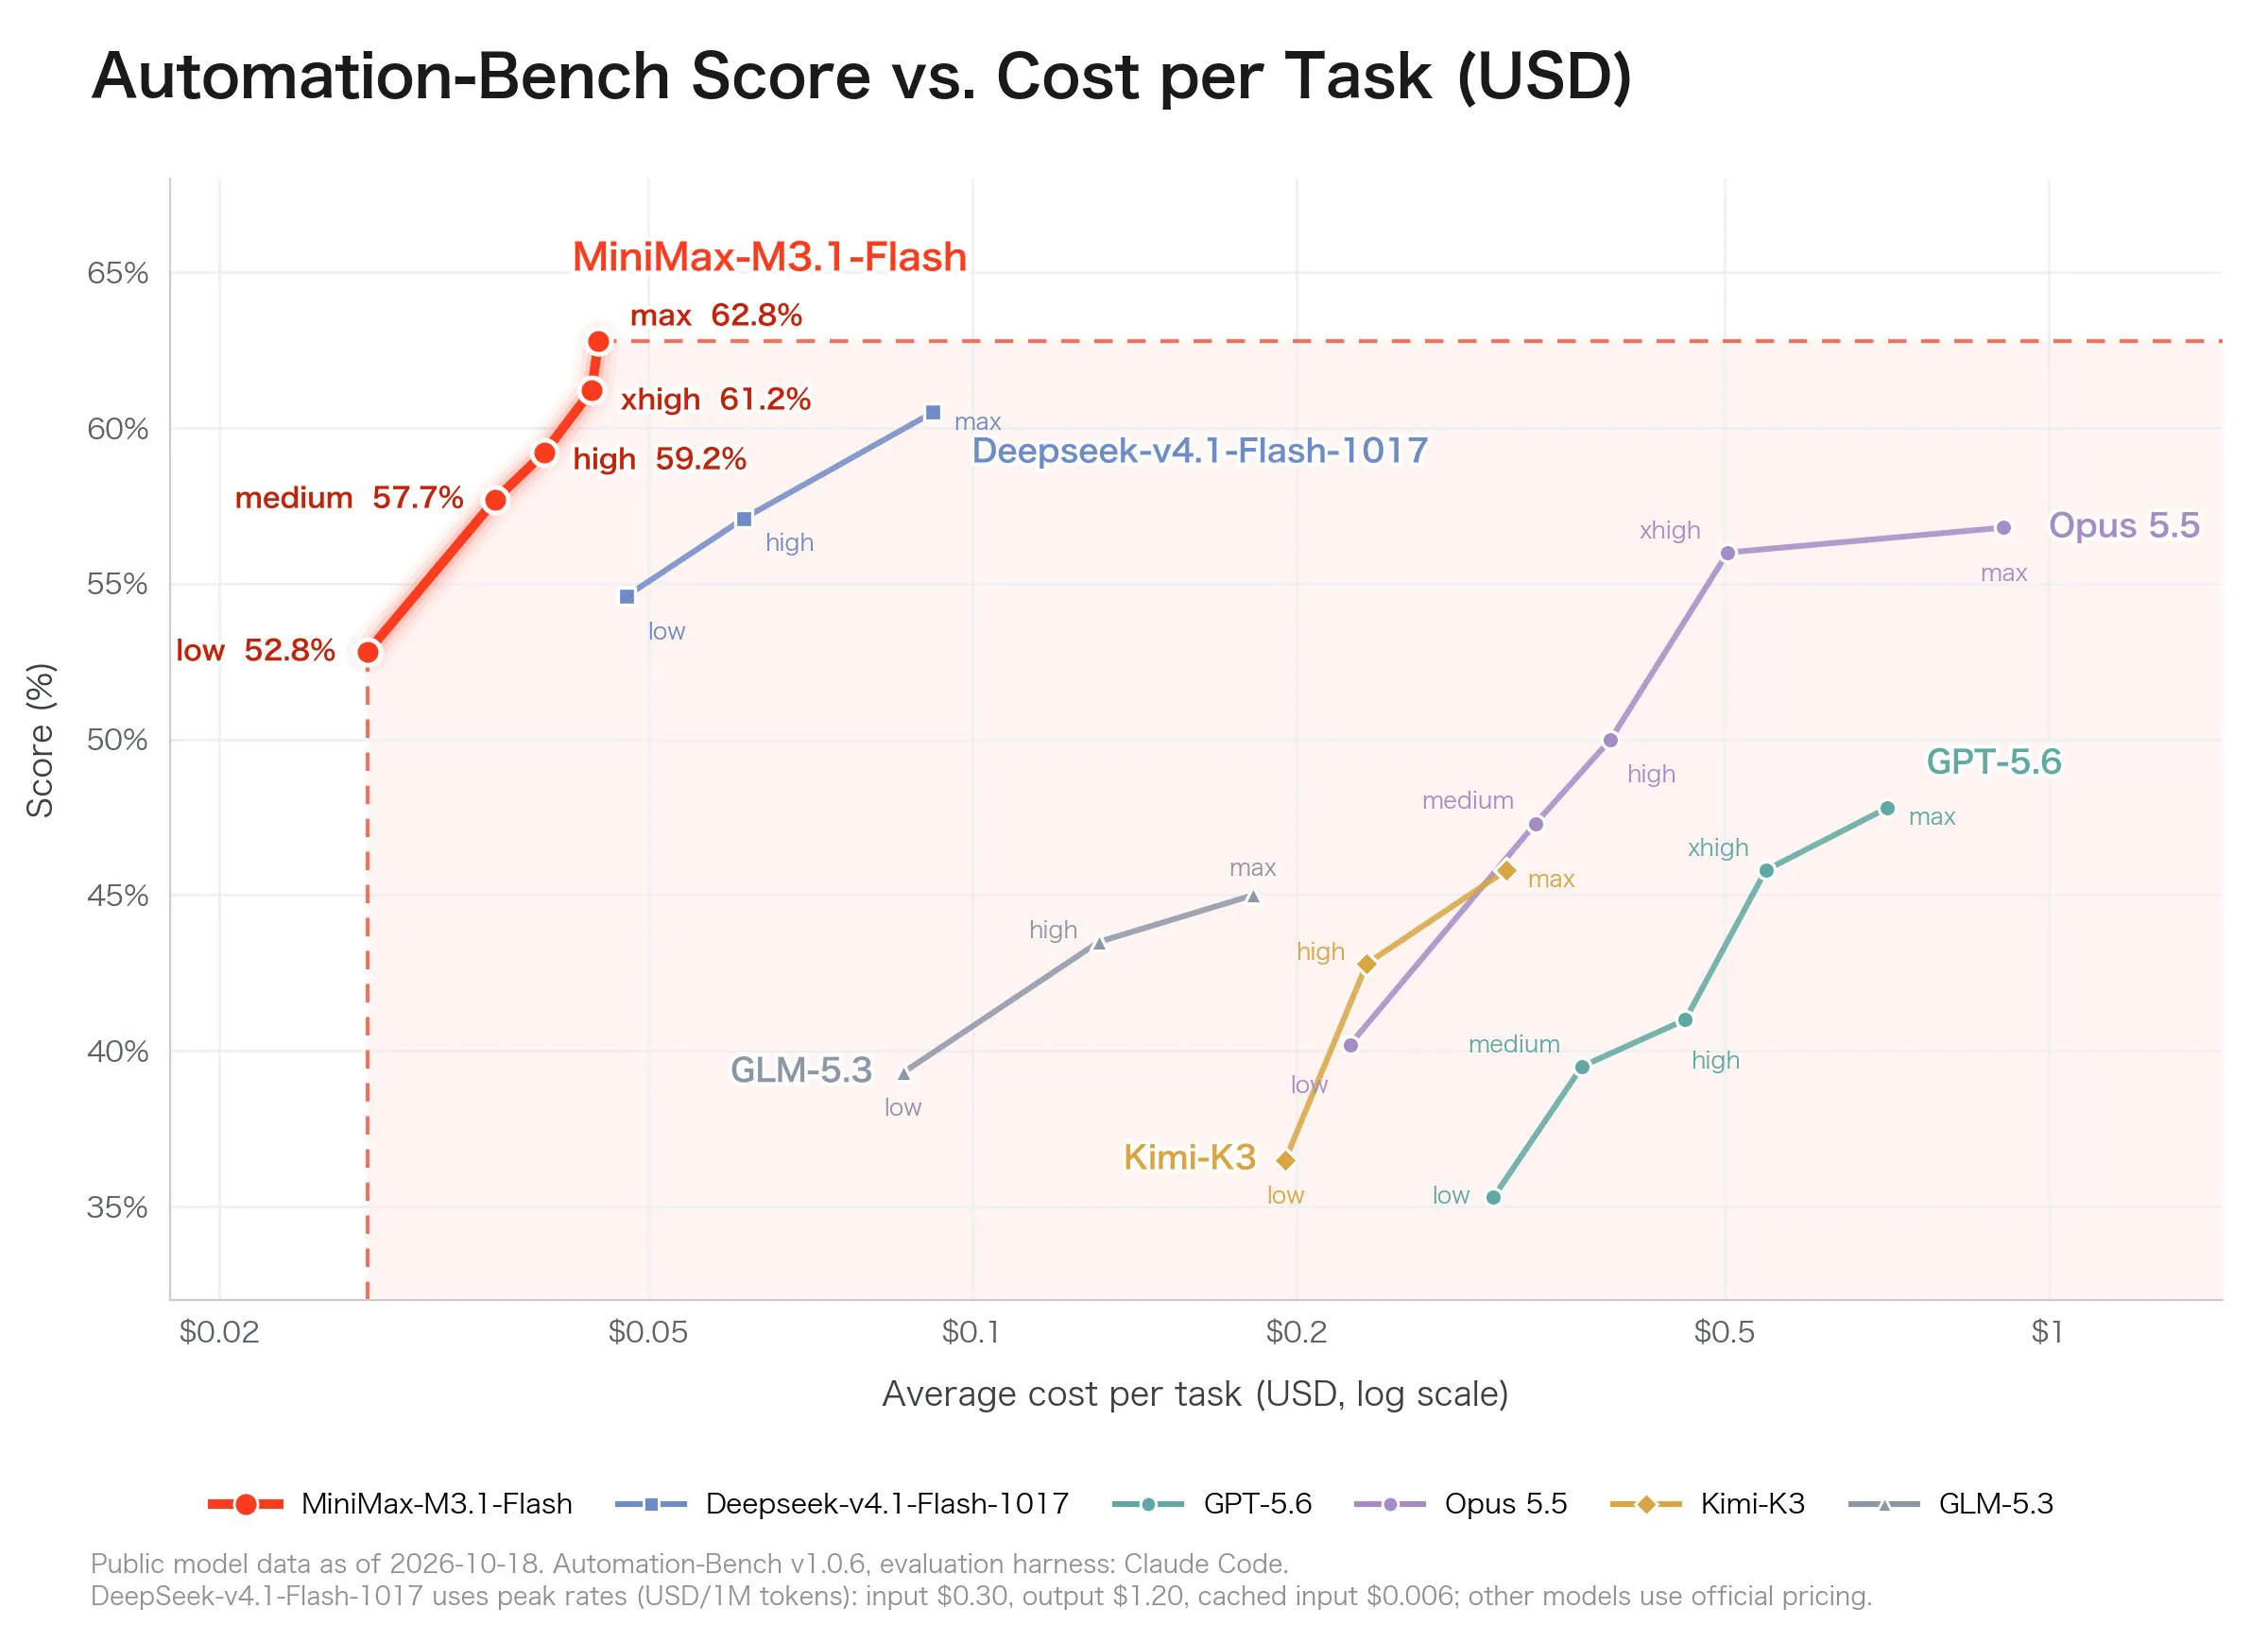
In AutomationBench erreicht M3.1 Flash rund 62 Prozent. Der Test bildet mehrstufige Abläufe über verschiedene Unternehmensdienste ab. Damit landet das Modell vor DeepSeek V4.1 Flash mit 55 Prozent sowie deutlich vor GPT-5.6, Claude Opus 5 und Kimi K3.
Quelle: MiniMax
Bei realistischen Softwareaufgaben erzielt M3.1 Flash in DeepSWE v1.1 rund 74 Prozent. Das liegt knapp hinter DeepSeek V4.1 Flash mit 77 Prozent und auf Augenhöhe mit Claude Opus 5 sowie GPT-5.6 Sol.
Auch abseits von Coding hält das Modell mit teureren Konkurrenten mit. BankerToolBench für komplexe Finanzabläufe schließt M3.1 Flash mit 76 Prozent ab. Hinzu kommen 43 Prozent in Humanity’s Last Exam ohne Werkzeuge und 91 Prozent im visuellen Reasoning-Test BabyVision.
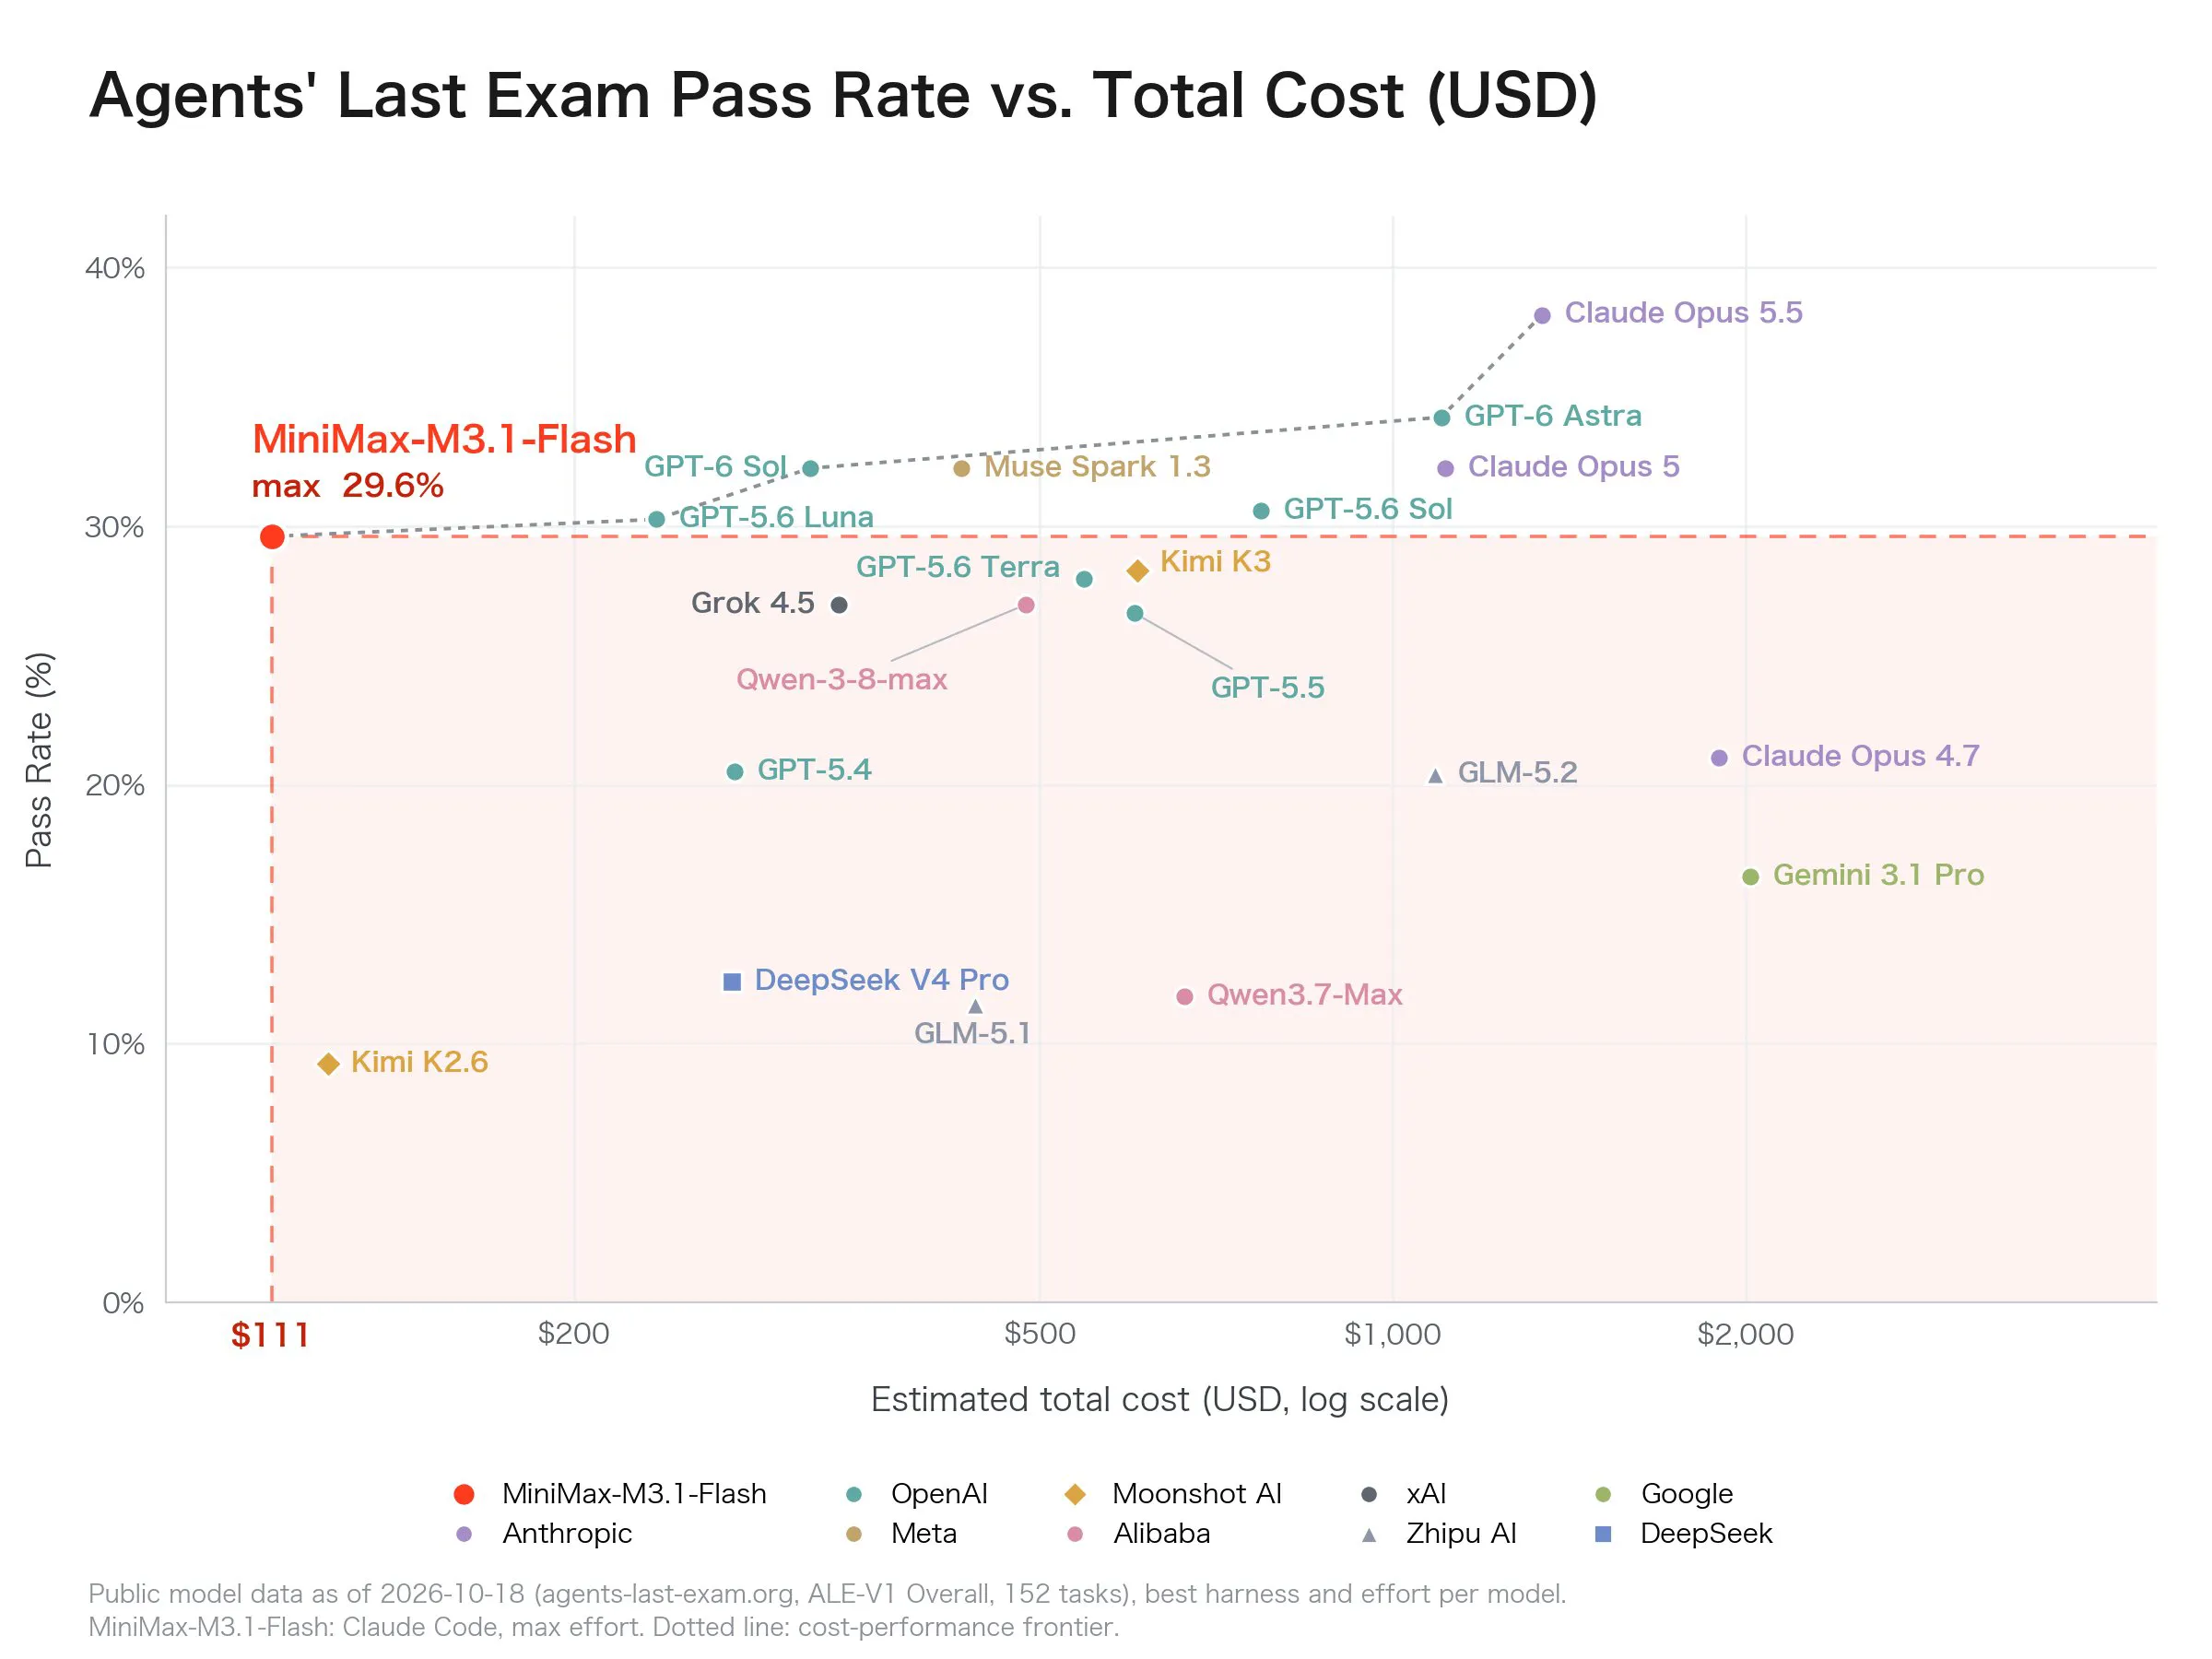
Die Kostenkurven sind dabei fast wichtiger als einzelne Spitzenplätze. Im AutomationBench kostet eine Aufgabe mit M3.1 Flash je nach Thinking-Stufe nur einen Bruchteil von Claude Opus 5 oder GPT-5.6.
Hinter Space Bunny steckte bereits MiniMax
Das zuvor anonym angebotene Modell »Space Bunny« war eine frühe Version von M3.1 Flash. Es verarbeitete laut MiniMax bereits mehr als 200 Billionen Token und führte zeitweise globale Nutzungsranglisten an.
Die finale Fassung erzeugt in der Spitze mehr als 200 Token pro Sekunde, im Median über 170. Nutzer können die Thinking-Tiefe in fünf Stufen von »low« bis »max« einstellen. Abschalten lässt sich das Reasoning nicht mehr.
M3.1 Flash verarbeitet dabei Text, Bilder und Videos. Das Kontextfenster fasst bis zu eine Million Token und eignet sich damit für große Codebasen, lange Dokumente und umfangreiche Agenten-Sitzungen.
Anzeige
API kostet 60 Cent pro Million Ausgabetoken
MiniMax berechnet 0,15 Dollar pro Million Eingabetoken und 0,60 Dollar für die Ausgabe. Gelesene Cache-Token kosten 0,015 Dollar pro Million. Gegenüber M3 sinken die regulären Tokenpreise damit um die Hälfte, bei agentischen Aufgaben spricht MiniMax von 70 Prozent niedrigeren Gesamtkosten.
M3.1 Flash ist über die API, den M Plan und MiniMax Code verfügbar. Die Modellgewichte sollen am 23. Oktober folgen. Eine konkrete Lizenz hat MiniMax noch nicht genannt.