Meta hat die erste Ausbaustufe seines KI-Superclusters Prometheus abgeschlossen und will das System auf rund eine Million GPUs erweitern. Schon heute verbindet der Standort in New Albany im US-Bundesstaat Ohio Hunderttausende Grafikprozessoren. Die erste Ausbaustufe trainierte bereits Metas neue Muse-Modelle.
Mehrere Rechenzentren arbeiten wie eine Maschine
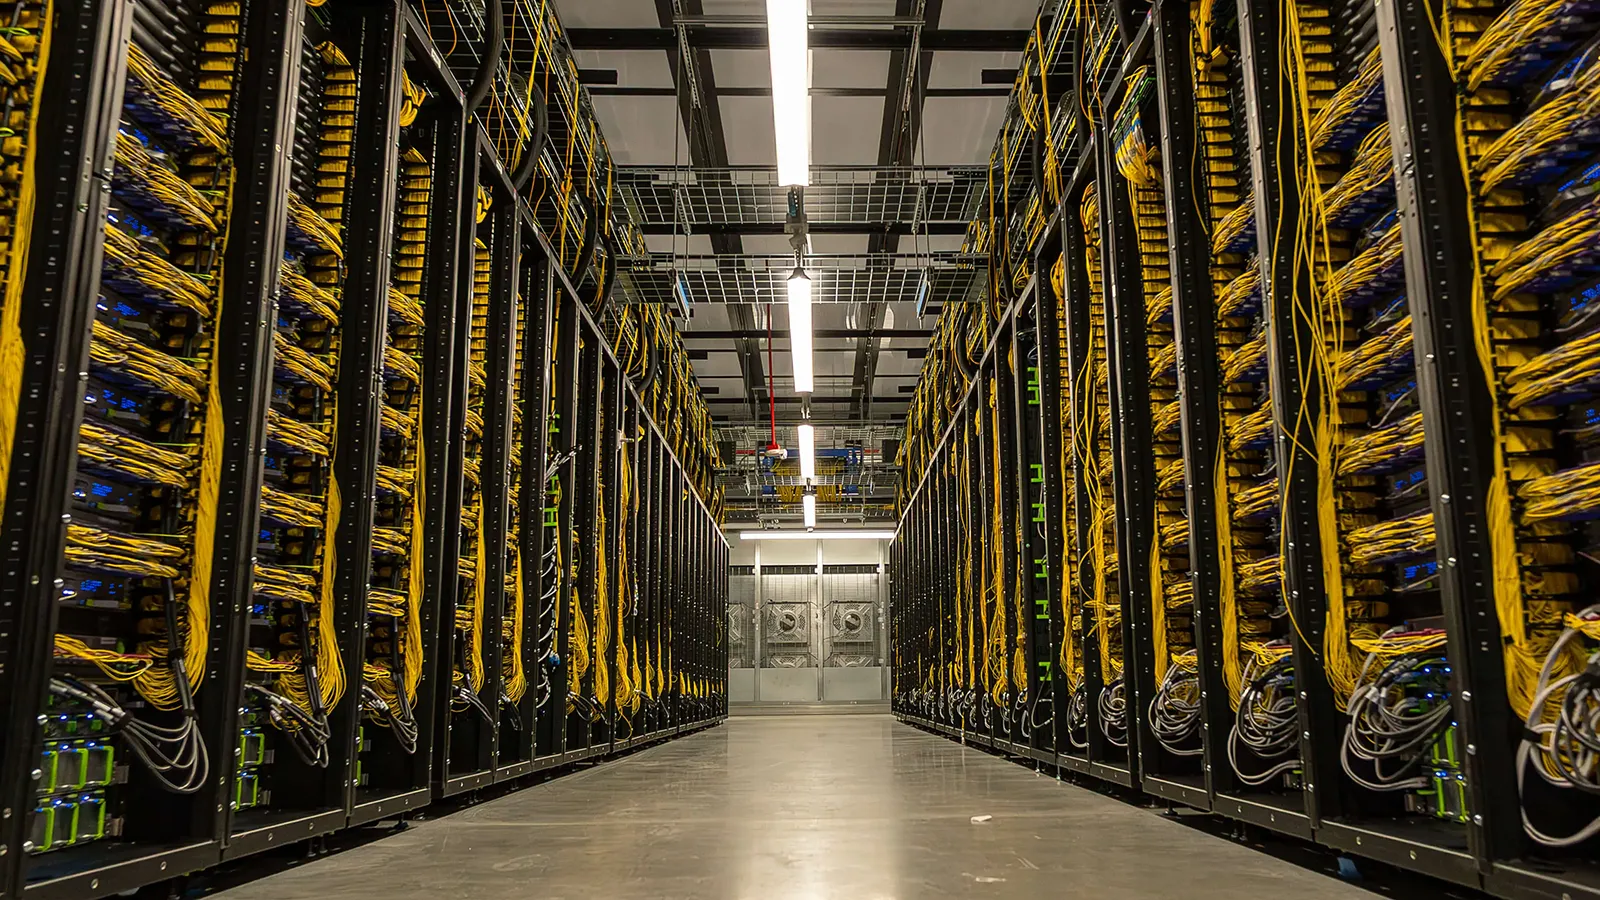
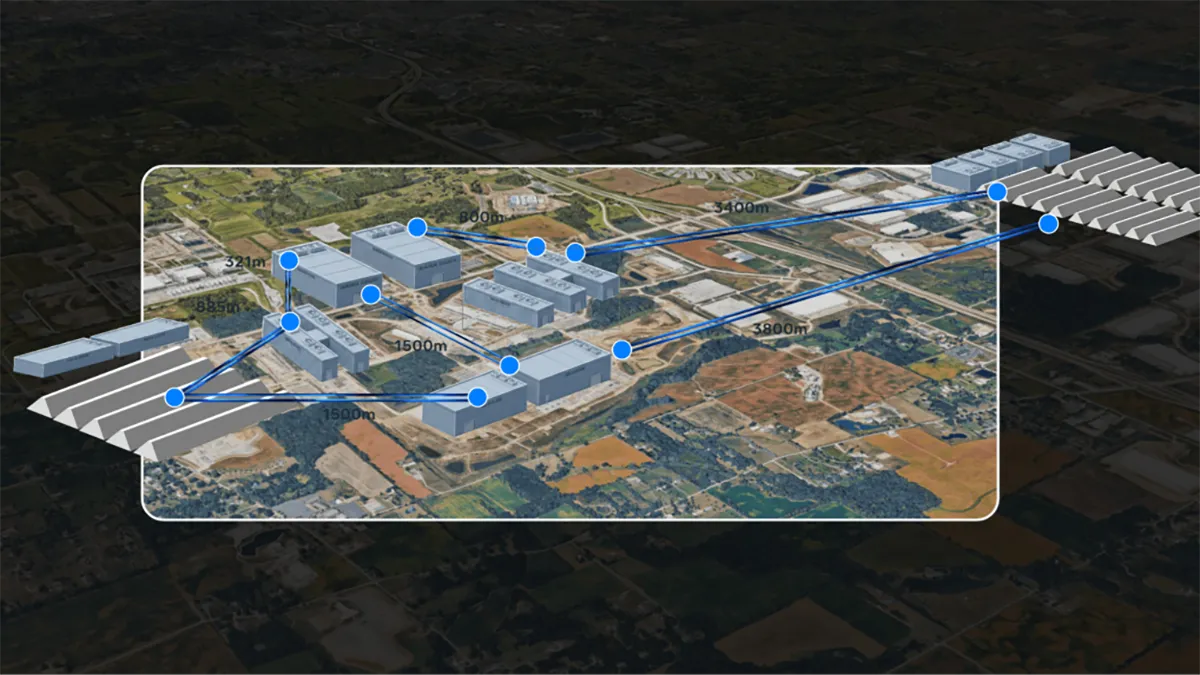
Prometheus verteilt seine Rechenleistung auf klassische Rechenzentren, neue KI-Gebäude und schnell errichtete Zusatzbauten. Ein eigenes Ethernet-Netz verbindet bis zu 20.736 GPUs pro Gebäude. Weitere Glasfaserstrecken koppeln die Standorte über Entfernungen von zwei bis mehr als 100 Kilometern.
Quelle: Meta
In den Racks arbeiten derzeit Nvidia GB200 und GB300 NVL72. Jede Einheit verbindet 72 GPUs zu einem gemeinsamen Rechenverbund. Die neuere GB300-Ausführung kommt auf mehr als ein Exaflop FP4-Rechenleistung und benötigt rund 135 Kilowatt pro Rack. Später soll Nvidias Vera-Rubin-Plattform mit mehr als 170 Kilowatt pro Rack folgen.
Anzeige
Reserve-GPUs fangen Ausfälle ab
Die Größe macht einzelne Defekte teuer. Meta nutzt deshalb in jedem 72-GPU-Rack nur 64 Grafikprozessoren aktiv und hält acht als Reserve bereit. Für einen Trainingslauf mit 32.768 aktiven GPUs plant das Unternehmen insgesamt 37.656 GPUs ein. Zusätzlich stehen rund zwei Prozent weitere Racks für komplette Rack-Ausfälle bereit.
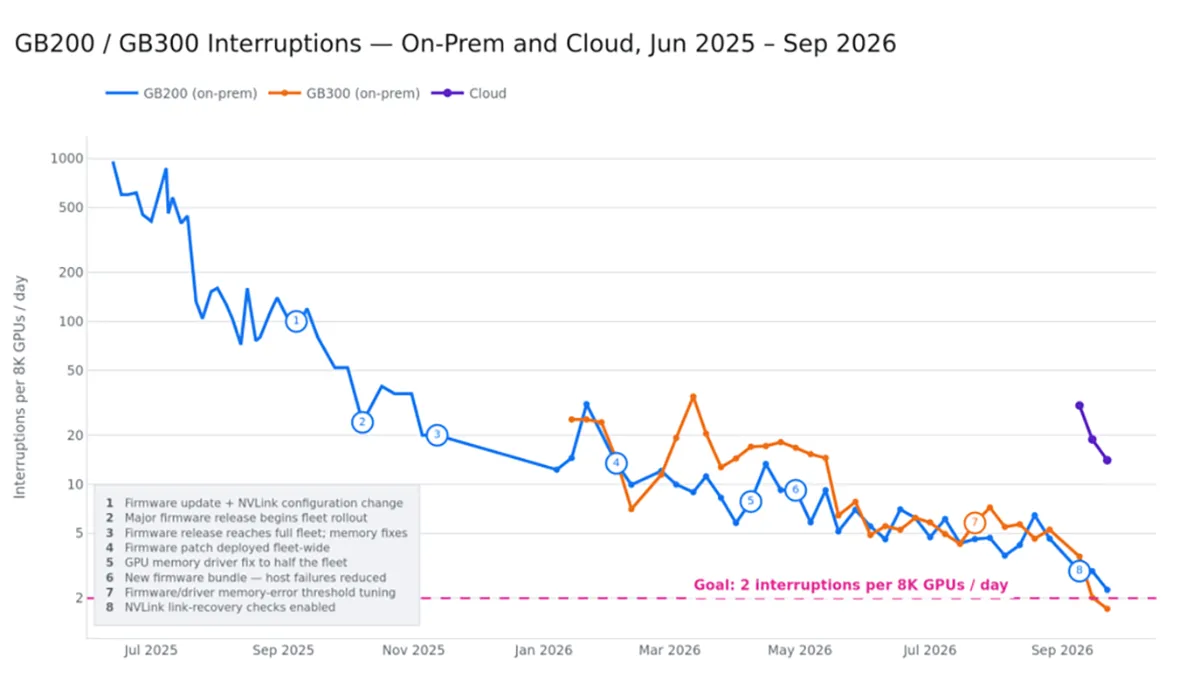
Mitte 2025 registrierte Meta zeitweise fast 1.000 Unterbrechungen pro 8.000 GPUs und Tag. Innerhalb eines Jahres sank diese Zahl um 99 Prozent. Beim Training von Muse Wonder erreichte der Cluster dadurch mehr als 85 Prozent produktive Rechenzeit im Vortraining und mehr als 90 Prozent beim Reinforcement Learning.
Quelle: Meta
Insgesamt zeigt das Beispiel Meta, wie groß die anfallenden Ressourcen mittlerweile sind. Die Preise, speziell für GPUs und RAM, dürften daher in nächster Zeit eher weniger fallen.